On-Premises
Inferenza AI on-premises. Controllo completo, velocità del cloud.
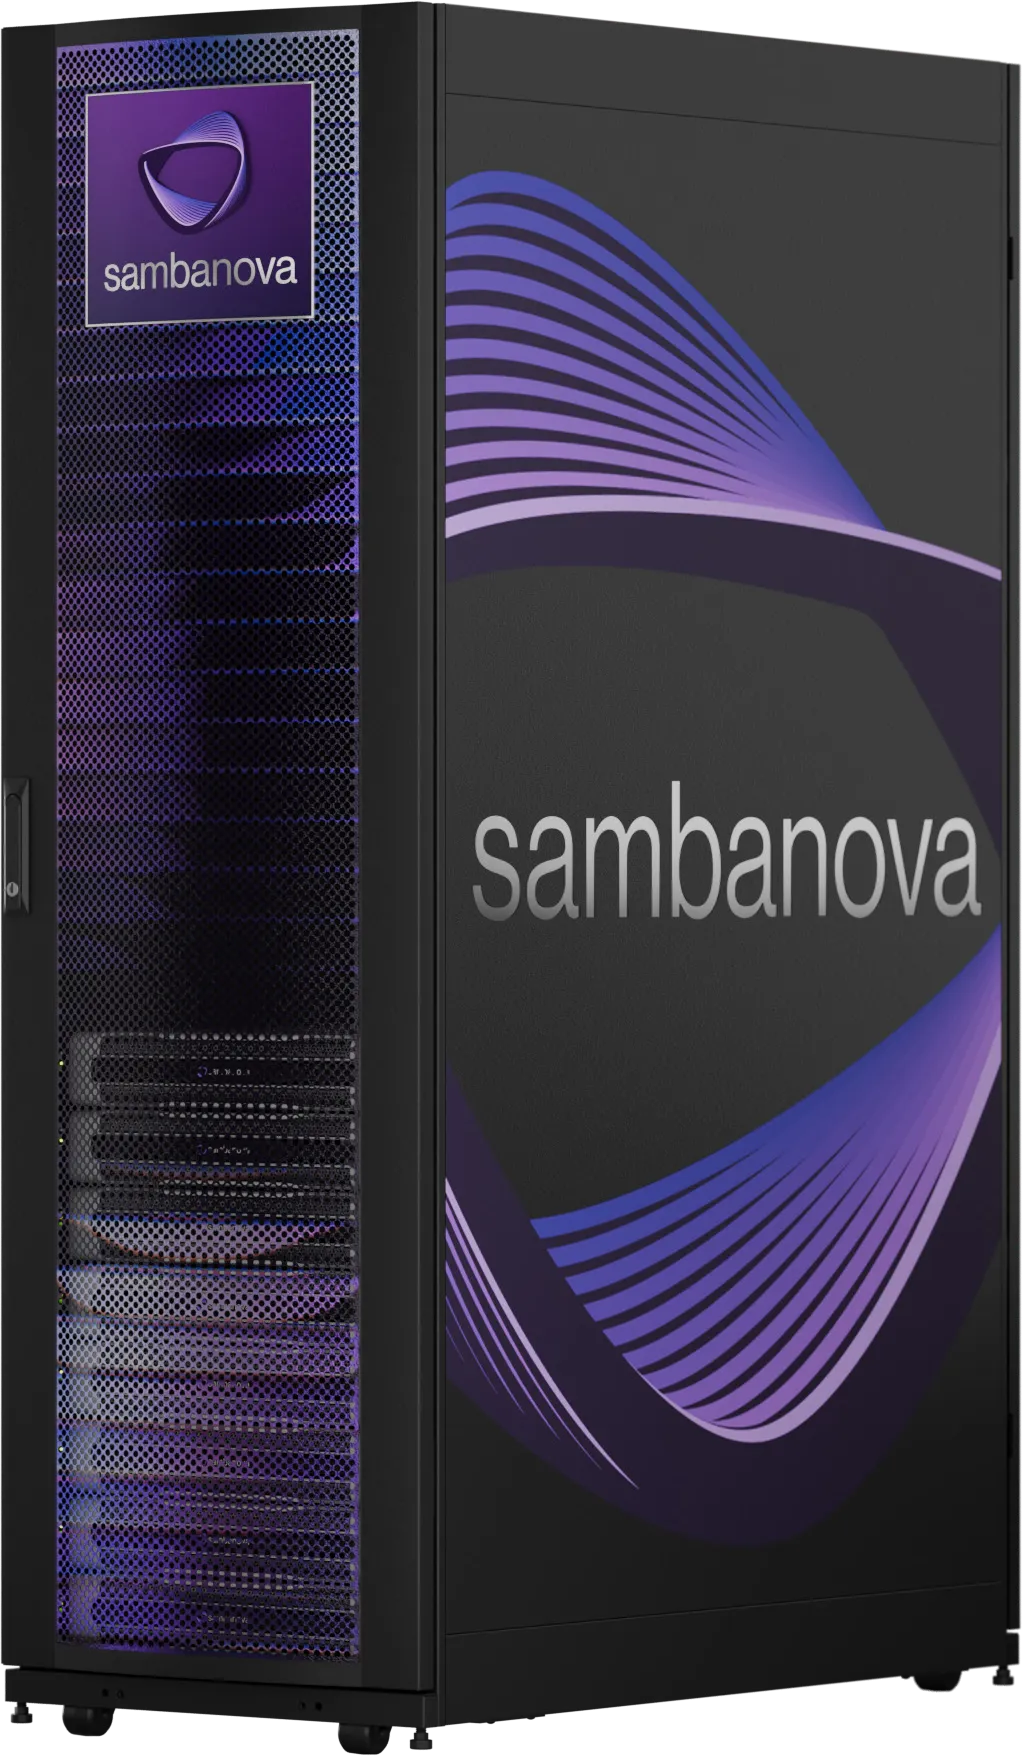
Gli stessi modelli e la stessa velocità del nostro cloud, ma su hardware di tua proprietà e sulla tua rete. I tuoi dati non lasciano mai l'edificio. I rack sono raffreddati ad aria e assorbono circa 10 kW, quindi si inseriscono nel datacenter che hai già.
Controllo completo dei dati, velocità del cloud
Quando i tuoi dati non possono uscire dall'azienda
La stessa piattaforma e la stessa velocità del nostro cloud, interamente dentro le tue mura. On-Premises è la scelta giusta quando dati o codice sorgente non possono fisicamente uscire dal tuo edificio, quando un'autorità di vigilanza o un cliente lo richiede, oppure quando hai deciso di possedere direttamente la tua infrastruttura AI. I rack sono raffreddati ad aria, senza raffreddamento a liquido né lavori speciali, quindi si inseriscono negli spazi che hai già. E se un workload non ha requisiti di questo tipo, il nostro cloud e Dedicated Capacity offrono la stessa velocità senza alcun investimento in hardware. Ti diciamo con onestà cosa è più adatto.
Quando conviene
Quando scegliere On-Premises
Quattro situazioni in cui possedere la piattaforma è la decisione giusta, non un ripiego.
Dati che non possono uscire
Codice sorgente, proprietà intellettuale o dati sensibili che per legge o per contratto devono restare dentro il tuo perimetro.
Un obbligo da rispettare
Un'autorità di vigilanza, un contratto con un cliente o una norma di settore impone l'elaborazione on-premises.
Controllo completo
Tieni tutte le chiavi e gestisci direttamente la piattaforma, sulla tua rete.
Proprietà
Capacità di inferenza di tua proprietà invece che in affitto, senza altri clienti sull'hardware. Model bundle e aggiornamenti software arrivano tramite il tuo contratto con noi.
Cosa ottieni
Lo stesso motore di inferenza, nel tuo edificio
Risposte veloci e a bassa latenza a ogni richiesta, con la stessa velocità del nostro cloud, ora nel tuo edificio. Poiché i chip sono progettati per l'inferenza, i rack sono raffreddati ad aria e in uso tipico assorbono circa 10 kW. Non servono raffreddamento a liquido né locali speciali. I rack si inseriscono nel tuo datacenter esistente, e ne aggiungi altri man mano che cresci.
Hardware
- Acceleratori AI di SambaNova progettati per l'inferenza - non GPU
- Generazione attuale: SambaRack SN40L
- Raffreddamento ad aria, ingombro rack standard - niente raffreddamento a liquido
- Un Core Services Rack per il control plane
- Dimensionato sul tuo workload, espandibile man mano che cresci
Software e supporto
- Piattaforma SambaStack (basata su Kubernetes)
- I modelli che gestiamo a Monaco di Baviera + Bring Your Own Checkpoint
- Un solo contratto con Infercom: dimensionamento, installazione, configurazione e supporto, forniti insieme agli ingegneri di SambaNova
- Supporto per deployment air-gapped
- Model bundle, aggiornamenti software e supporto tecnico
La tua parte
Cosa fornisce il tuo team
I requisiti di sito di SambaNova, in breve. Li esaminiamo con te punto per punto durante il sopralluogo.
- Spazio nel datacenter, alimentazione (trifase 400/415 V), raffreddamento e rete
- Un cluster Kubernetes: il tuo, oppure installato sul Core Services Rack
- PostgreSQL, logging e monitoraggio (SambaNova consiglia Prometheus e Grafana)
- DNS, NTP, due URL con certificati TLS e autenticazione tramite OIDC, LDAP o Keycloak
- Aggiornamenti regolari: resti al massimo una release indietro, così le correzioni ti arrivano
- Solo per air-gap: un server di staging per gli artefatti, un container registry e 15 TB di storage condiviso
Un rack in numeri
- Chip
- 16 RDU
- Memoria
- 1 TB HBM, 4-24 TB DDR
- Potenza
- circa 10 kW tipici, 16,4 kW max
- Alimentazione
- trifase 400/415 V, 2 PDU
- Raffreddamento
- Aria, dal fronte al retro
- Control plane
- Un Core Services Rack
Fonte: SambaNova, requisiti di sito per SambaStack On-Premises (marzo 2026). I valori esatti per il tuo sito seguono con il sopralluogo.
Il processo
Dal contratto alla produzione
- 01
Consulenza e sopralluogo
Valutiamo i tuoi requisiti, lo stato del tuo datacenter e le tue esigenze di modelli, e dimensioniamo il deployment.
- 02
Consegna e installazione
I rack vengono consegnati e installati nel tuo datacenter insieme agli ingegneri di SambaNova.
- 03
Configurazione
Configurazione di SambaStack, messa in servizio dei modelli e integrazione, anche in ambienti air-gapped.
- 04
Produzione
Il tuo team gestisce la piattaforma. Model bundle, aggiornamenti e supporto arrivano tramite il tuo contratto con noi.
In genere ~90 giorni dal contratto alla produzione
I tempi dipendono dalla disponibilità dell'hardware e dallo stato del datacenter. Una data certa arriva dopo il sopralluogo.
Modelli
Il catalogo completo, nel tuo edificio
Ogni modello che gestiamo a Monaco di Baviera gira anche On-Premises, insieme ad altri modelli supportati da SambaStack e ai tuoi fine-tune.
- I modelli che gestiamo a Monaco di Baviera, più i modelli messi in servizio su richiesta
- BYOC - i fine-tune di architetture supportate si caricano subito
- Modelli con la precisione con cui chi li pubblica li ha rilasciati
- Supporto per deployment air-gapped
Nei deployment air-gapped, gli aggiornamenti di modelli e software vengono consegnati e installati manualmente. Serve quindi un ambiente di staging dalla tua parte.
Powered by SambaNova
La stessa architettura dataflow
On-Premises usa la stessa architettura dataflow di SambaNova che alimenta il nostro cloud: chip progettati per l'AI con un'inferenza fino a 10x più veloce rispetto alle GPU, raffreddati ad aria in un rack standard. Ottieni le stesse prestazioni, e l'hardware è tuo.
FAQ
Domande e risposte, senza giri di parole
Le prestazioni on-premises sono le stesse del vostro cloud?
Sì, è lo stesso hardware, quindi ottieni la stessa velocità. On-Premises cambia posizione e proprietà, non le prestazioni: i rack stanno nel tuo datacenter e le chiavi le tieni tu.
Possedere l'hardware conviene davvero rispetto ai token gestiti?
On-Premises è un investimento con dei tempi di consegna. I token gestiti invece sono subito disponibili e non richiedono investimenti. Se l'hardware proprio convenga dipende dal singolo caso. Con un utilizzo alto e costante su più anni può essere economicamente vantaggioso, ma dipende da quanto lo sfrutti, quindi facciamo i conti insieme invece di prometterlo. Spesso il fattore decisivo non è il costo: codice sorgente o dati che non possono uscire dal tuo edificio, un cliente o un'autorità di vigilanza che lo richiede, oppure la decisione strategica di possedere l'infrastruttura. Le prestazioni sono comunque identiche al nostro cloud. Se non c'è un requisito vincolante e i conti sono al limite, la Inference API o Dedicated Capacity sono di solito la scelta migliore, e te lo diciamo.
Possiamo fare un test prima di acquistare l'hardware?
Sì, e lo consigliamo. Dimostra prima il valore sulla Inference API condivisa, che gira sullo stesso hardware, poi eventualmente su un rack dedicato nel nostro datacenter a Monaco di Baviera, prima di qualsiasi investimento. Un piccolo pilota va fatto nel cloud, non on-premises.
Quanto deve essere grande un deployment?
Lo dimensioniamo sul tuo workload: quanti utenti, quanti contemporaneamente e cosa eseguono (prompt brevi, contesto lungo, agenti). Da lì proponiamo il numero di rack, e puoi aggiungerne altri in seguito. Se stai ancora validando il caso d'uso, inizia con la Inference API o Dedicated Capacity.
Cosa serve nel nostro datacenter - spazio, alimentazione, raffreddamento?
Un datacenter standard con alimentazione per rack ad alta densità. I rack sono raffreddati ad aria (niente raffreddamento a liquido), assorbono circa 10 kW in uso tipico e al massimo 16,4 kW, e sono alimentati in trifase 400/415 V tramite due PDU, con un ingombro rack standard. Si inseriscono quindi in un datacenter che hai già, senza bisogno di una struttura dedicata. Oltre a spazio, alimentazione, raffreddamento e rete, il tuo team fornisce i servizi elencati sopra. Con un sopralluogo verifichiamo alimentazione, raffreddamento, rete e storage prima di qualsiasi spedizione.
Come funziona un deployment air-gapped, e come lo aggiornate e diagnosticate?
SambaStack funziona completamente offline. In un ambiente air-gapped, gli aggiornamenti di software e modelli vengono consegnati e installati manualmente: fornisci un server di staging per gli artefatti, un container registry e uno storage condiviso, e convalidi ogni aggiornamento secondo i tuoi processi di sicurezza. La diagnostica avviene tramite trasferimento di file e videoconferenza, perché nessuno dall'esterno ha accesso di rete al tuo cluster. È una configurazione collaudata, ma un air-gap scambia un po' di rapidità nel supporto con l'isolamento totale: ogni aggiornamento è un passaggio manuale e deliberato, non un download automatico.
Quanto dura il deployment?
Calcola circa 90 giorni dal contratto alla produzione, per consegna, installazione, configurazione e messa in servizio dei modelli. I tempi dipendono dai volumi dell'ordine e dalla disponibilità dell'hardware, dallo stato del tuo datacenter e dall'eventuale messa in servizio di nuove architetture di modelli. Ci impegniamo su una data certa solo dopo un sopralluogo.
Quali modelli possiamo usare, e possiamo portare i nostri?
Ogni modello che gestiamo a Monaco di Baviera gira anche On-Premises, e SambaStack supporta altri modelli che possiamo mettere in servizio per te. Anche Bring Your Own Checkpoint funziona: i fine-tune di architetture supportate si caricano subito. Il fine-tuning in sé gira su GPU: addestri il modello, poi carichi i pesi sui tuoi rack. Il supporto per architetture completamente nuove è una questione commerciale.
Come funzionano gli aggiornamenti dei modelli quando l'hardware è da noi?
Ogni release di SambaStack include nuovi modelli. Scegli quali usare, li testi e decidi tu l'allocazione, per esempio spostando rack tra due modelli. Riconfigurare un rack (ad esempio da contesto lungo a contesto corto) richiede circa 30 minuti. Resti al massimo una release indietro, così le correzioni ti arrivano. In un ambiente air-gapped questi aggiornamenti vengono consegnati e installati manualmente.
Come gestisce la piattaforma molti utenti in contemporanea?
Con l'inference router dai priorità a determinati utenti e ne limiti le richieste, così nessun singolo utente può monopolizzare il cluster. Quando il cluster è a pieno carico, le richieste vanno in coda: il tempo al primo token aumenta, la velocità di output di una richiesta in corso no. Questi controlli sono nelle tue mani, perché la piattaforma la gestisci tu.
Possiamo installarlo nel nostro datacenter, o lo ospitate voi?
Sono possibili entrambe le cose. Possiamo venderti l'hardware per il tuo datacenter, ospitarlo per te in colocation o offrire colocation as a service, a seconda delle tue esigenze di controllo e di gestione.
Potete garantire per contratto che nessuno fuori dalla nostra organizzazione possa vedere i nostri dati?
On-premises e in air-gap, tutte le chiavi sono tue, noi non abbiamo alcun accesso durante l'esecuzione e nulla lascia la tua rete. La KV cache resta solo in memoria e non viene mai scritta su disco. In memoria non è cifrata.
Quanto siamo autonomi dopo l'installazione?
Nel quotidiano la piattaforma la gestisce il tuo team. Model bundle, aggiornamenti software, correzioni e supporto tecnico fanno parte del tuo contratto con noi, forniti insieme agli ingegneri di SambaNova, che conoscono la piattaforma fino al chip. Se preferisci, la gestiamo noi per te come managed service.
Cosa succede se un rack si guasta?
Con più rack, gli altri continuano a servire le richieste e perdi solo la quota di capacità di quel rack. Il control plane gira su tre nodi nel Core Services Rack. Ogni rack ha due alimentatori.
Possiamo installarlo in più paesi?
Sì. Ogni sito è un deployment a sé. Alcuni paesi richiedono una verifica sul controllo delle esportazioni prima della spedizione dell'hardware. La chiariamo durante il sopralluogo.
Confronto tra le opzioni
Non sai quale scegliere?
La maggior parte dei team dimostra prima il valore nel cloud e passa a On-Premises solo quando un requisito lo impone.
Vuoi valutare On-Premises?
Parliamo dei tuoi requisiti e dello stato del tuo datacenter.