Inferenza AI sovrana UE
La tua AI, in Europa. Più veloce di quanto sei abituato.
Inferenza AI veloce di cui mantieni il controllo: modelli open-weight su hardware progettato per l'AI, di nostra proprietà e gestito da noi a Monaco di Baviera. Un'unica API compatibile con OpenAI, dalla tua prima chiave API alla capacità riservata solo a te.
Agenti che non ti fanno aspettare.
Risposte prima che la pausa diventi imbarazzante.
Il suo appuntamento è spostato a martedì alle 10:30. Posso fare altro per lei?
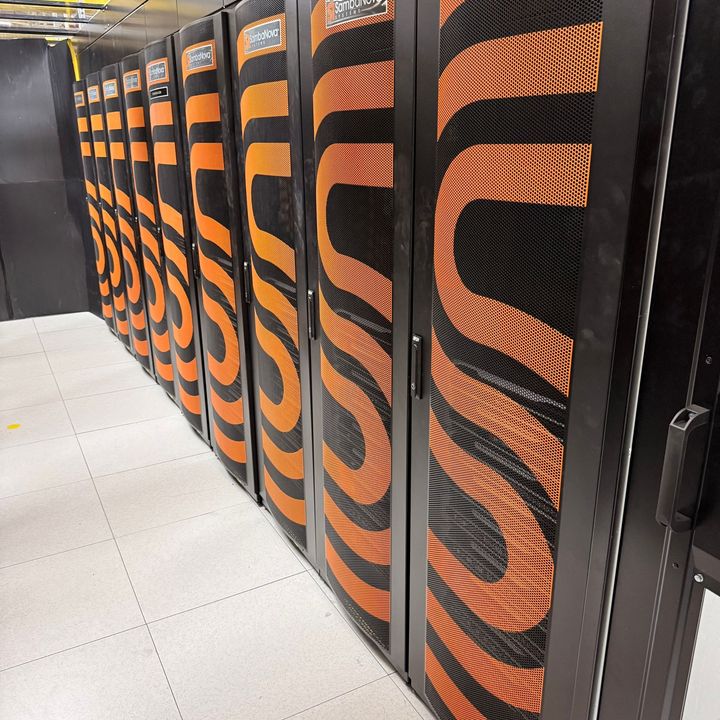
I tuoi dati restano in Europa.
- Modelli sovrani UE
- Zero Data Retention Policy
- Certificazione ISO 27001
Persone che puoi raggiungere.
- Società lussemburghese, nessuna capogruppo USA
- Un team con cui parli direttamente
- Dalla prima chiave ai tuoi rack
Throughput di output, p50, 10K input / 1K output, singola richiesta. Ultima misurazione: luglio 2026.
Perché conta
Due cose che fanno fallire i prodotti AI
Decide qualcun altro
I tuoi dati, i tuoi modelli e il tuo servizio dipendono da un provider. Quando cambiano la sua legge, il suo proprietario o il suo catalogo, cambia anche il tuo prodotto.
Risposte lente
I voice agent si inceppano, i coding agent si bloccano, gli utenti se ne vanno. Per molti prodotti la velocità non è un dettaglio. È il prodotto.
Cosa facciamo
LLM open-weight sul nostro hardware
Siamo un provider di inferenza: gestiamo LLM open-weight su hardware di nostra proprietà, in un datacenter a Monaco di Baviera. Solo inferenza: non addestriamo modelli, e prompt e output non vengono mai archiviati in modo persistente.
- Società lussemburghese, controllata in Europa, nessuna capogruppo USA
- Modelli sovrani UE elaborati a Monaco di Baviera
- Ogni dipendenza dichiarata nel DPA
Perché è veloce
Progettato per l'inferenza, non riadattato
Chip progettati per l'AI tengono i dati di lavoro del modello accanto al calcolo, così i dati non viaggiano avanti e indietro come sulle GPU. Il risultato è un'inferenza fino a 10x più veloce rispetto alle alternative basate su GPU, misurata sulla nostra API di produzione con metodo pubblicato.
Modelli
LLM open-weight ospitati a Monaco di Baviera
Inizia subito con la nostra Inference API, oppure esegui modelli più grandi su capacità riservata a te.
Disponibili sulla Inference API
Pagamento per token e pronti da subito, con la precisione con cui i produttori li hanno rilasciati.
Disponibili su Dedicated Capacity
Modelli più grandi su capacità riservata a te a Monaco di Baviera e gestita da noi. Tempi di consegna su richiesta.
Provalo
Cambia con una riga
Punta il tuo SDK OpenAI al nostro endpoint e scegli un modello. Nient'altro cambia nel tuo codice.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.infercom.ai/v1",  # the one line that changes
    api_key="your-api-key",
)

response = client.chat.completions.create(
    model="gpt-oss-120b",
    messages=[{"role": "user", "content": "Hello from Munich"}],
)
Crescere senza cambiare
La stessa API, dalla prima chiave a Dedicated Capacity
Parti dalla Inference API e cresci da lì. Cambiano solo il modello operativo e la località. Il tuo codice e le prestazioni restano gli stessi.
- 01Developer Paghi a token e inizi in pochi minuti.
- 02Enterprise Un impegno mensile con rate limit di produzione e priorità.
- 03Dedicated Capacity Capacità riservata a te a Monaco di Baviera, per modelli grandi come GLM-5.3 e MiniMax M3.1 Flash. La gestiamo noi.
- 04On-Premises Su richiesta: rack nel tuo datacenter.
Chi ci costruisce sopra
Router, piattaforme e soluzioni europee girano su Infercom





That device is limited and we need infrastructure, and private infrastructure. That's why we are working with Infercom, to actually run bigger models with lower latency.
 Levent AkyilCEO & CTO, co-mind.ai
Chi siamo
Pensiamo noi all'infrastruttura, così puoi concentrarti sul tuo prodotto
Scegliamo e progettiamo l'infrastruttura adatta a ogni compito e la gestiamo per te. Oggi sono i chip di SambaNova, progettati per l'inferenza veloce. Un piccolo team europeo che raggiungi direttamente, con una roadmap che puoi influenzare.