Tecnologia
Chip progettati per un'inferenza AI veloce
Eseguiamo modelli open su hardware scelto per il compito. Per un'inferenza veloce oggi è il SN40L di SambaNova: chip che fanno scorrere il modello attraverso il chip invece di spostare continuamente i dati avanti e indietro dalla memoria, così le risposte arrivano prima.
Throughput di output, p50, 10K input / 1K output, singola richiesta. Ultima misurazione: luglio 2026.
L'inferenza è un problema di memoria, non di calcolo
Un modello linguistico scrive la risposta un token alla volta. Per ogni token una GPU preleva i pesi del modello dalla memoria, calcola e riscrive il risultato. Il viaggio verso la memoria dura molto più del calcolo stesso, quindi in questa fase, chiamata decode, la GPU passa la maggior parte del tempo ad aspettare. I provider mascherano l'attesa raggruppando molti utenti in un batch: il sistema produce più token in totale, ma ogni singola risposta arriva più lentamente.
Dataflow: niente deviazioni attraverso la memoria
Il chip di SambaNova, la RDU (Reconfigurable Dataflow Unit), distribuisce sul chip le operazioni di un intero strato del modello e vi fa scorrere i dati. I pesi arrivano dalla memoria ad alta larghezza di banda (HBM) nello stesso package. Tutto ciò che viene calcolato nel mezzo resta sul chip, invece di tornare in memoria dopo ogni passaggio. Così il chip usa quasi l'85% della sua larghezza di banda di memoria per i pesi (SambaNova, paper sul SN40L).
Ogni chip può accedere alla memoria di tutti i 16 chip di un rack. Per questo un solo rack gestisce modelli con diverse centinaia di miliardi di parametri.
Il compromesso
Un chip elabora un piccolo batch di richieste alla volta. Così ogni risposta resta veloce. Per i job in blocco, dove nessuno aspetta la risposta, conta di più il throughput massimo del batch che la velocità per richiesta.
Cosa cambia in pratica
Sviluppatori
Token veloci per ogni richiesta, non solo in aggregato: 713 tok/s con gpt-oss-120b e 428 tok/s con MiniMax M2.7, misurati sulla nostra API. Un agente completa più passaggi nello stesso tempo.
Team di piattaforma
Modelli grandi su un solo rack. Più modelli restano in memoria contemporaneamente e si alternano in millisecondi, così un rack dedicato può servire i tuoi checkpoint fine-tuned fianco a fianco. Contesti lunghi: 192K token su MiniMax M2.7, 128K su gpt-oss-120b e Gemma 4. Su MiniMax M2.7 il contesto ripetuto arriva da una cache dei prompt nella memoria dei chip e non viene mai scritto su disco.
Direzione e sostenibilità
È la minore movimentazione dei dati a rendere veloce il chip, e fa anche risparmiare energia: una richiesta che finisce prima assorbe potenza per meno tempo, e un modello grande sta su meno chip. SambaNova indica un'efficienza energetica fino a 5 volte superiore a quella di una GPU (da 2,5x a 5,6x rispetto a una NVIDIA H200 con Llama 70B, a seconda della dimensione del batch, 2025). Un rack assorbe circa 10 kW nel funzionamento tipico ed è raffreddato ad aria, quindi si adatta ai datacenter che esistono oggi.
Come scegliamo cosa gira sotto
Siamo un provider di inferenza, non un produttore di chip. Valutiamo qualsiasi hardware con cinque domande, in questo ordine:
- 01
Si adatta ai datacenter che ci sono in Europa?
Alimentazione e raffreddamento vengono prima. I rack raffreddati ad aria si installano ovunque, mentre la capacità per il raffreddamento a liquido è scarsa.
- 02
Esiste uno stack software completo?
Un chip non è un servizio. Servono il compilatore, il runtime e il livello di serving che lo trasformano in un'API.
- 03
Quanto è veloce con i modelli che usano i nostri clienti?
Modelli open grandi e aggiornati, misurati da noi.
- 04
Quanto costa in totale?
Hardware, energia e gestione per milione di token.
- 05
Dove gira e chi lo gestisce?
Su hardware di nostra proprietà, nell'UE.
Per un'inferenza veloce, oggi il SN40L di SambaNova risponde meglio a queste domande, e ogni modello che serviamo da Monaco di Baviera gira su di esso. Qualunque cosa giri sotto, chiami la stessa API.
Specifiche del SN40L
Chip: SambaNova SN40L RDU
- Processo
- TSMC 5nm
- Package
- Due die in un package (CoWoS)
- Unità di calcolo
- 1.040 (PCU)
- Picco di calcolo (BF16)
- 638 TFLOPS
- Memoria per chip
- 520 MB SRAM, 64 GB HBM, fino a 1,5 TB DDR
Rack: SambaRack SN40L-16
- Chip
- 16 RDU
- Picco di calcolo (BF16)
- 10.2 PFLOPS
- Memoria
- 8 GB SRAM, 1 TB HBM, 12 TB DDR
- Potenza
- 7-14,5 kW in inferenza, 10 kW tipici
- Raffreddamento
- Aria
- Dimensioni (A x L x P)
- 1994 x 610 x 1270 mm
- Peso
- 485 kg
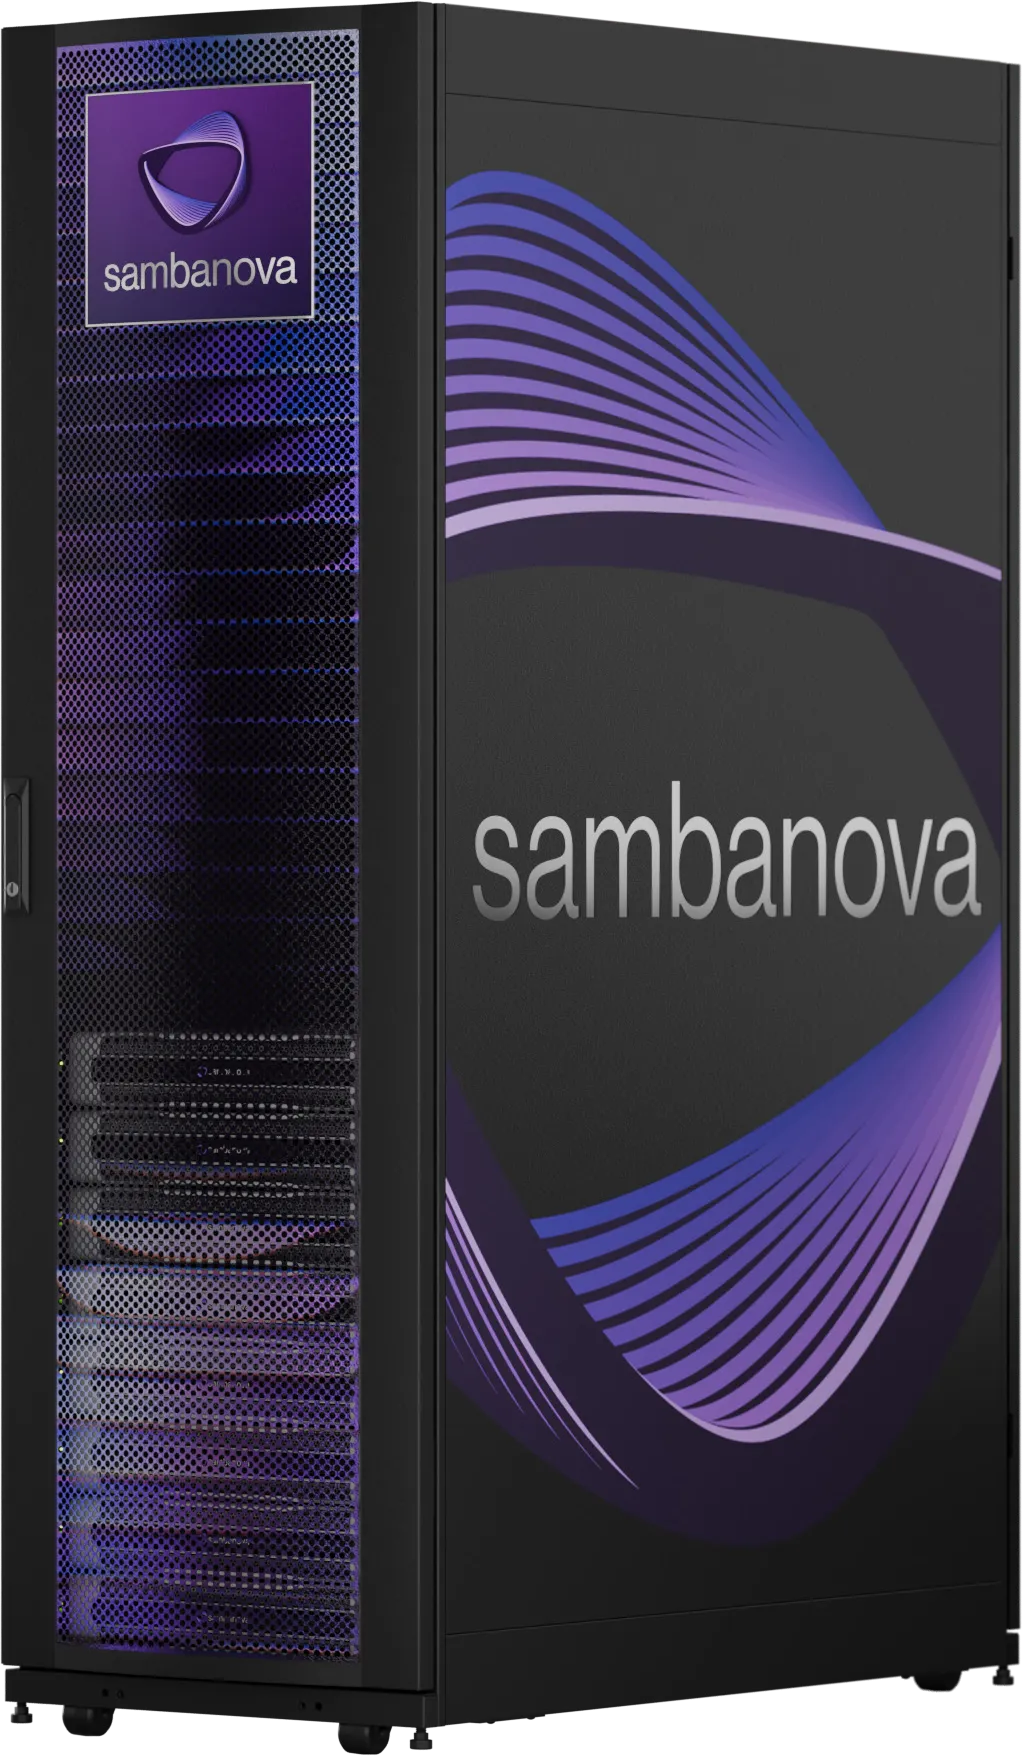
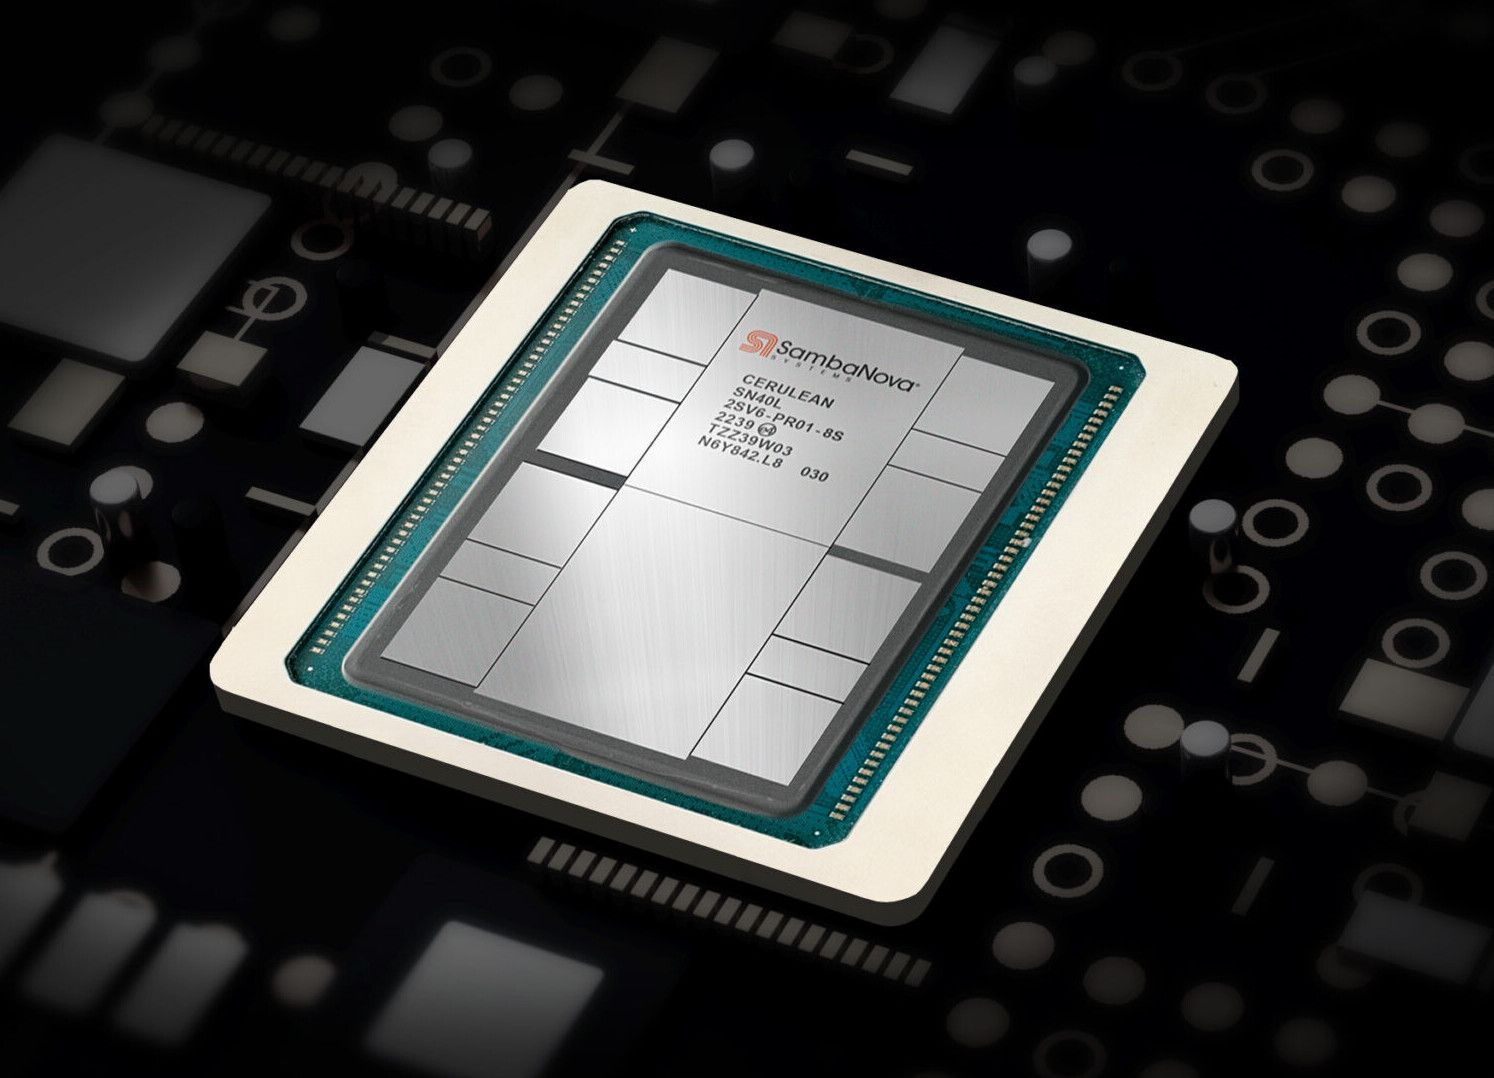
La nostra installazione: 8 rack con 128 RDU presso Equinix Monaco 4.
A Monaco di Baviera, su hardware nostro
- Equinix Monaco 4, Germania. I rack appartengono a Infercom.
- Il datacenter usa elettricità al 100% rinnovabile, tramite garanzie di origine.
- Si raffredda con dry cooler e free cooling. I chip non usano acqua per il raffreddamento.
- Il datacenter è certificato ISO 27001, ISO 14001 e ISO 50001.
Il software di SambaNova esegue i modelli, e SambaNova supporta parte della gestione. Cosa significa per i tuoi dati
Domande
Che cos'è una Reconfigurable Dataflow Unit (RDU)?
È il chip AI di SambaNova. Invece di eseguire un modello passo dopo passo tornando in memoria tra un passaggio e l'altro, distribuisce le operazioni del modello sul chip e vi fa scorrere i dati. Infercom usa la generazione SN40L.
Perché il dataflow è più veloce di una GPU per l'inferenza?
Mentre scrive una risposta, una GPU esegue uno strato del modello in tanti passaggi separati e riscrive in memoria i risultati intermedi. Un chip dataflow esegue l'intero strato in un solo passaggio e tiene quei risultati sul chip, così usa la larghezza di banda di memoria per i pesi e risponde prima.
Quale hardware usa Infercom?
Sistemi SambaRack SN40L-16 con chip SambaNova SN40L: 8 rack con 128 chip presso Equinix Monaco 4. Li abbiamo scelti per un'inferenza veloce.
Usate il SN50 di SambaNova?
No, i nostri rack usano il SN40L, e tutti i dati di questa pagina si riferiscono al SN40L.
Quanta energia usa un rack, e serve il raffreddamento a liquido?
Circa 10 kW nel funzionamento tipico (7-14,5 kW in inferenza). Il raffreddamento a liquido non serve: il rack è raffreddato ad aria e si adatta ai datacenter costruiti per i server normali.
Un rack può eseguire più modelli?
Sì, più modelli restano in memoria contemporaneamente e il rack passa dall'uno all'altro in millisecondi. Su un rack dedicato puoi quindi eseguire i tuoi checkpoint fine-tuned fianco a fianco.
Per approfondire
- Paper sull'architettura del SN40L Il chip, i suoi tre livelli di memoria e il cambio di modello, descritti dagli ingegneri di SambaNova (arXiv, in inglese).
- Scheda tecnica SambaRack SN40L-16 Specifiche del rack: chip, memoria, potenza e dimensioni (SambaNova, in inglese).
- Intelligence per Watt Studio indipendente sull'efficienza energetica degli acceleratori AI, incluso il SN40L (Stanford, arXiv, in inglese).
- Intelligence per Joule SambaNova sull'efficienza energetica come misura per l'infrastruttura AI (in inglese).
- 713 token al secondo: l'architettura dietro Ultraspeed Il nostro approfondimento su dataflow e decode, con le misurazioni di maggio 2026.
- Glossario RDU, architettura dataflow, prefill e decode, token al secondo.