Teknologi
Chips udviklet til hurtig AI-inferens
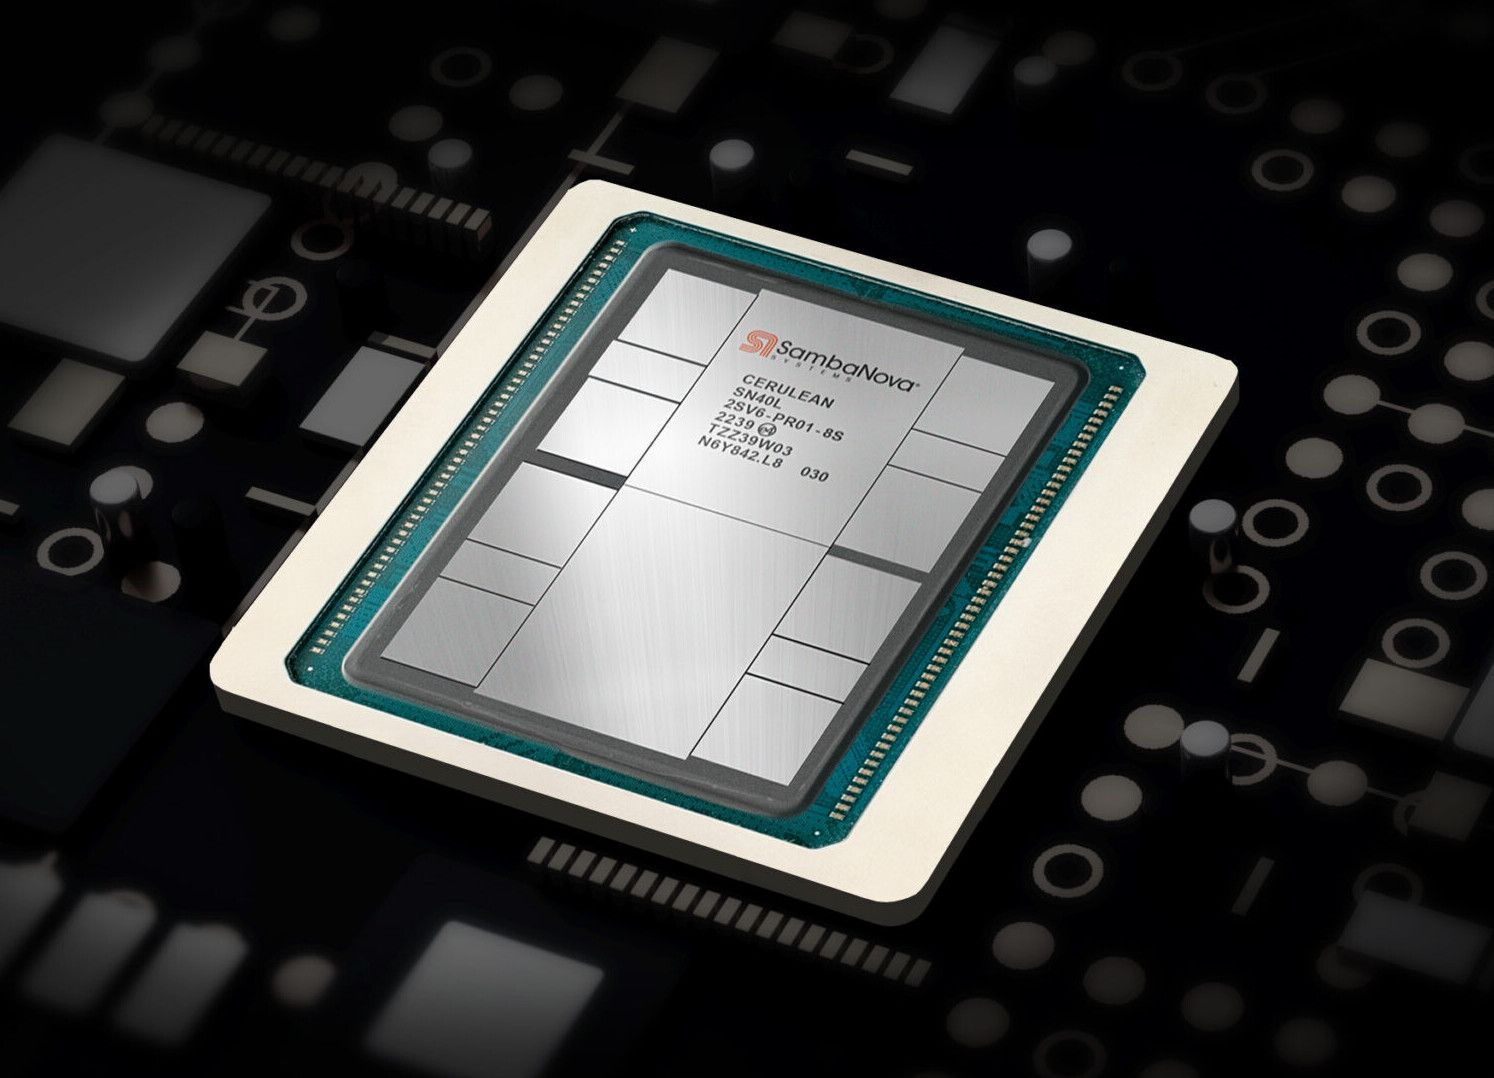
Vi kører åbne modeller på hardware, der er valgt til opgaven. Til hurtig inferens er det i dag SambaNovas SN40L: chips, der lader modellen strømme gennem chippen i stedet for at flytte data frem og tilbage til hukommelsen, så svarene kommer hurtigere.
Output-throughput, p50, 10K input / 1K output, én forespørgsel. Senest målt: juli 2026.
Inferens er et hukommelsesproblem, ikke et beregningsproblem
En sprogmodel skriver sit svar ét token ad gangen. For hvert token henter en GPU modellens vægte fra hukommelsen, regner og skriver resultatet tilbage. Turen til hukommelsen tager langt længere tid end selve beregningen, så i denne fase, kaldet decode, bruger GPU'en det meste af tiden på at vente. Udbydere skjuler ventetiden ved at samle mange brugere i én batch: Systemet producerer flere tokens i alt, men hvert enkelt svar kommer langsommere.
Dataflow: ingen omveje gennem hukommelsen
SambaNovas chip, RDU'en (Reconfigurable Dataflow Unit), fordeler beregningstrinnene for et helt modellag ud over chippen og lader data strømme igennem dem. Vægtene hentes fra højbåndbreddehukommelsen (HBM) i samme pakke. Alt, hvad der beregnes undervejs, bliver på chippen i stedet for at gå tilbage til hukommelsen efter hvert trin. Derfor kan chippen bruge næsten 85% af sin hukommelsesbåndbredde på vægtene (SambaNova, artikel om SN40L).
Hver chip kan tilgå hukommelsen på alle 16 chips i et rack. Derfor kan ét rack køre modeller med flere hundrede milliarder parametre.
Afvejningen
En chip behandler en lille batch af forespørgsler ad gangen. Det holder hvert svar hurtigt. Ved store batchjob, hvor ingen venter på svaret, betyder den maksimale throughput i batch mere end hastigheden per forespørgsel.
Hvad det ændrer i praksis
Udviklere
Hurtige tokens for hver enkelt forespørgsel, ikke kun samlet: 713 tok/s med gpt-oss-120b og 428 tok/s med MiniMax M2.7, målt på vores API. En agent når flere trin på samme tid.
Platformteams
Store modeller på ét rack. Flere modeller ligger i hukommelsen på samme tid og skifter på millisekunder, så et dedikeret rack kan køre dine fine-tunede checkpoints side om side. Lange kontekster: 192K tokens på MiniMax M2.7, 128K på gpt-oss-120b og Gemma 4. På MiniMax M2.7 hentes gentaget kontekst fra en prompt-cache i chippenes hukommelse og skrives aldrig til disk.
Ledelse og bæredygtighed
Mindre dataflytning er det, der gør chippen hurtig, og det sparer også energi: En forespørgsel, der bliver færdig hurtigere, bruger strøm i kortere tid, og en stor model passer på færre chips. SambaNova oplyser op til 5x bedre energieffektivitet end en GPU (2,5x til 5,6x mod en NVIDIA H200 med Llama 70B, afhængigt af batchstørrelse, 2025). Et rack bruger omkring 10 kW ved typisk drift og er luftkølet, så det passer ind i de datacentre, der findes i dag.
Sådan vælger vi, hvad der kører nedenunder
Vi er en inferensudbyder, ikke en chipproducent. Vi vurderer al hardware ud fra fem spørgsmål, i denne rækkefølge:
- 01
Passer det ind i de datacentre, Europa har?
Strøm og køling kommer først. Luftkølede racks kan stå alle steder, mens kapacitet til væskekøling er knap.
- 02
Findes der en komplet software-stack?
En chip er ikke en tjeneste. Vi har brug for den compiler, runtime og serving-lag, der gør den til et API.
- 03
Hvor hurtigt kører det med de modeller, vores kunder bruger?
Store, aktuelle åbne modeller, målt af os selv.
- 04
Hvad koster det i alt?
Hardware, strøm og drift per million tokens.
- 05
Hvor kører det, og hvem driver det?
På hardware, vi selv ejer, i EU.
Til hurtig inferens besvarer SambaNovas SN40L disse spørgsmål bedst i dag, og alle modeller, vi leverer fra München, kører på den. Uanset hvad der kører nedenunder, kalder du det samme API.
Specifikationer for SN40L
Chip: SambaNova SN40L RDU
- Proces
- TSMC 5nm
- Pakke
- To dies i én pakke (CoWoS)
- Beregningsenheder
- 1.040 (PCU'er)
- Maksimal ydelse (BF16)
- 638 TFLOPS
- Hukommelse per chip
- 520 MB SRAM, 64 GB HBM, op til 1,5 TB DDR
Rack: SambaRack SN40L-16
- Chips
- 16 RDU'er
- Maksimal ydelse (BF16)
- 10.2 PFLOPS
- Hukommelse
- 8 GB SRAM, 1 TB HBM, 12 TB DDR
- Effekt
- 7-14,5 kW ved inferens, typisk 10 kW
- Køling
- Luft
- Mål (H x B x D)
- 1994 x 610 x 1270 mm
- Vægt
- 485 kg
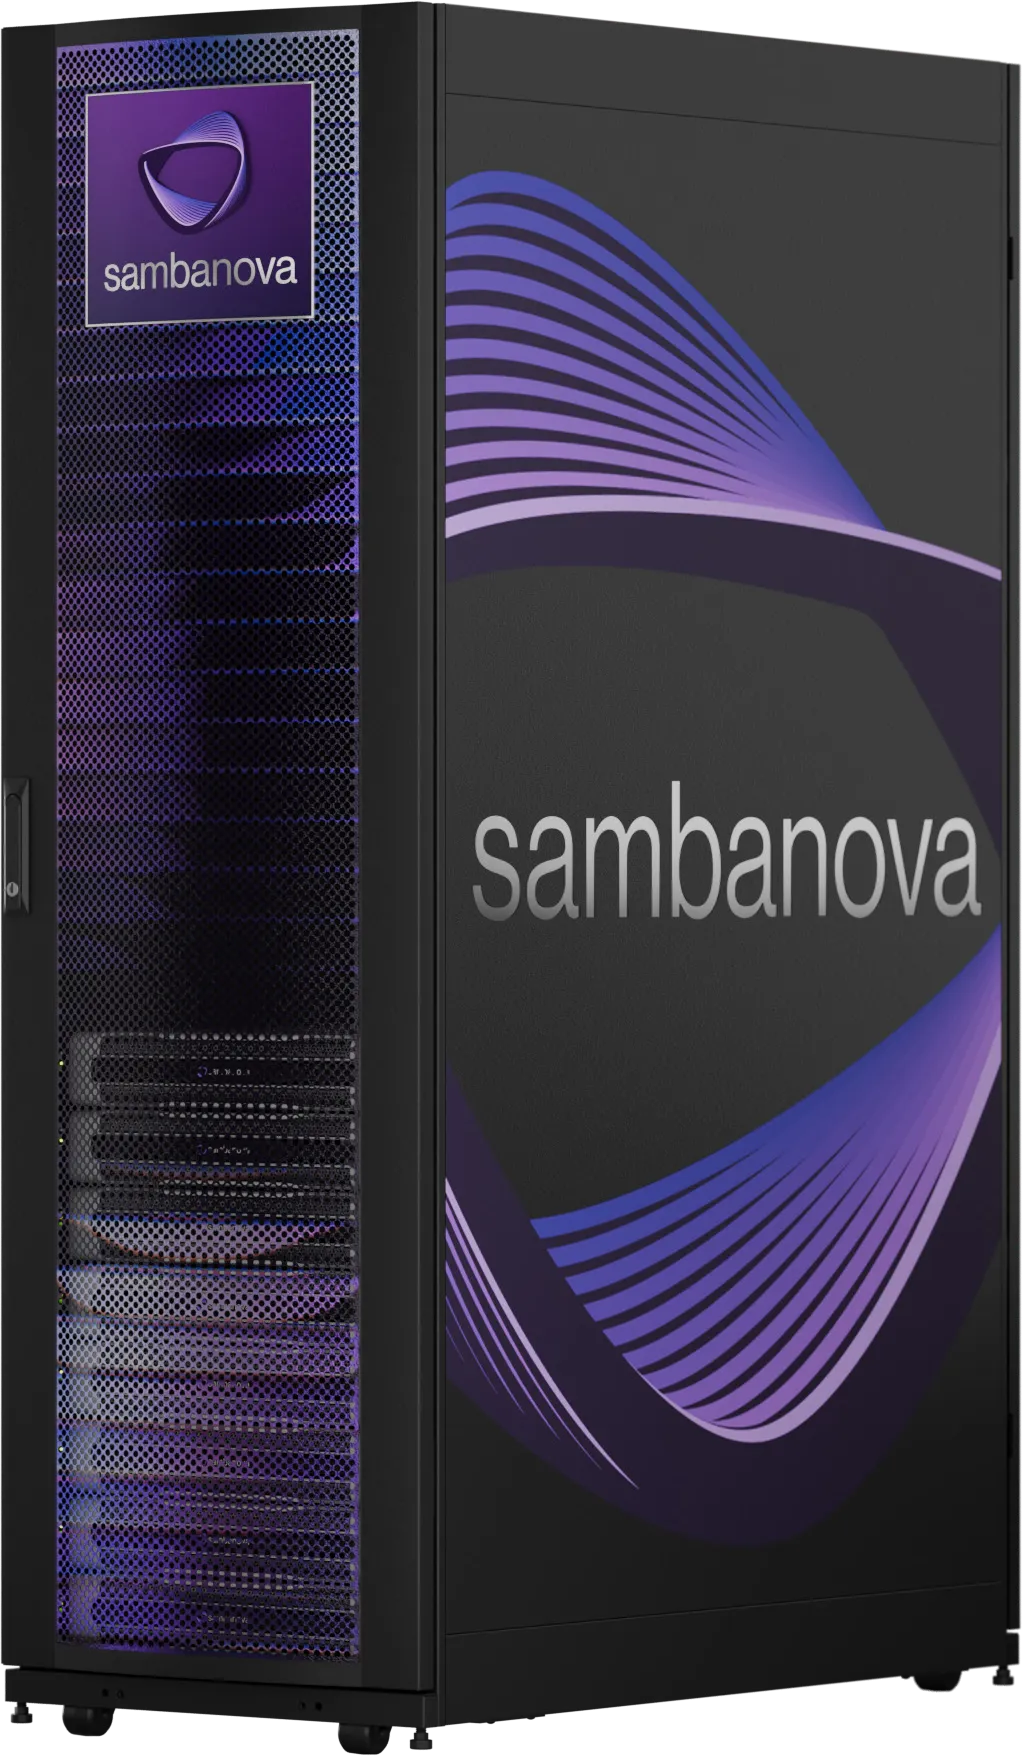
Vores installation: 8 racks med 128 RDU'er hos Equinix München 4.
I München, på hardware vi ejer
- Equinix München 4, Tyskland. Racks'ene tilhører Infercom.
- Datacentret kører på 100% vedvarende strøm via oprindelsesgarantier.
- Det køler med tørkølere og frikøling. Chippene bruger ikke vand til køling.
- Datacentret er certificeret efter ISO 27001, ISO 14001 og ISO 50001.
SambaNovas software kører modellerne, og SambaNova hjælper med dele af driften. Hvad det betyder for dine data
Spørgsmål
Hvad er en Reconfigurable Dataflow Unit (RDU)?
Det er SambaNovas AI-chip. I stedet for at køre en model trin for trin og gå tilbage til hukommelsen imellem, fordeler den modellens beregningstrin ud over chippen og lader data strømme igennem dem. Infercom kører generationen SN40L.
Hvorfor er dataflow hurtigere end en GPU til inferens?
Mens en GPU skriver et svar, kører den et modellag som mange separate trin og skriver resultaterne imellem tilbage til hukommelsen. En dataflow-chip kører hele laget som ét trin og holder resultaterne på chippen, så den bruger sin hukommelsesbåndbredde på vægtene og svarer hurtigere.
Hvilken hardware kører Infercom?
SambaRack SN40L-16-systemer med SambaNovas SN40L-chips: 8 racks med 128 chips hos Equinix München 4. Vi har valgt dem til hurtig inferens.
Kører I SambaNovas SN50?
Nej, vores racks kører SN40L, og alle tal på denne side gælder for SN40L.
Hvor meget strøm bruger et rack, og kræver det væskekøling?
Omkring 10 kW ved typisk drift (7-14,5 kW ved inferens). Væskekøling er ikke nødvendig: Racket er luftkølet og passer ind i datacentre, der er bygget til almindelige servere.
Kan ét rack køre flere modeller?
Ja, flere modeller ligger i hukommelsen på samme tid, og racket skifter mellem dem på millisekunder. På et dedikeret rack kan du derfor køre dine egne fine-tunede checkpoints side om side.
Læs mere
- Arkitekturartikel om SN40L Chippen, dens tre hukommelseslag og modelskift, beskrevet af SambaNovas ingeniører (arXiv, på engelsk).
- Datablad for SambaRack SN40L-16 Rackets specifikationer: chips, hukommelse, effekt og mål (SambaNova, på engelsk).
- Intelligence per Watt Uafhængig undersøgelse af energieffektivitet på tværs af AI-acceleratorer, herunder SN40L (Stanford, arXiv, på engelsk).
- Intelligence per Joule SambaNova om energieffektivitet som målestok for AI-infrastruktur (på engelsk).
- 713 tokens i sekundet: arkitekturen bag Ultraspeed Vores dybdegående artikel om dataflow og decode, med målingerne fra maj 2026.
- Ordliste RDU, dataflow-arkitektur, prefill og decode, tokens per sekund.