Men hastighedstal siger ikke meget, før man forstår, hvor de kommer fra.
Vi er hardwareuafhængige. Vores opgave er at vurdere inferensarkitekturer og bruge den bedste løsning til hver workload. Til memory-bound decode på store modeller kører vi i dag SambaNovas dataflow-arkitektur, fordi den løser den hukommelsesflaskehals, der begrænser inferens på GPU'er. Denne artikel forklarer de tekniske grunde bag valget. Detaljer om driften finder du i vores teknologioversigt.
Decode-flaskehalsen
For at forstå, hvorfor noget inferens er hurtigere end andet, hjælper det at se på, hvad der sker, når du sender en prompt til en LLM. Der foregår to adskilte faser, og de belaster hardwaren på helt forskellige måder.
Prefill behandler hele din prompt. Modellen læser alle tokens på én gang og finder ud af, hvordan hvert ord hænger sammen med alle de andre, det såkaldte "attention". Alle input-tokens behandles parallelt, og det er præcis det, GPU'er er bygget til. Tusindvis af kerner har travlt, udnyttelsen er høj, og alt fungerer efter hensigten. Prefill opbygger også KV-cachen, en hukommelsesstruktur med mellemresultater fra attention, så modellen ikke skal beregne dem igen for hvert nyt token.
Decode genererer output-tokens ét ad gangen. Hvert nyt token afhænger af alle de foregående, så arbejdet er sekventielt af natur. For hvert token skal modellen læse de aktive vægte fra hukommelsen, læse hele KV-cachen, beregne forudsigelsen og tilføje det nye tokens data til cachen. Selve beregningen går hurtigt i forhold til hukommelsesadgangen, og det meste af tiden går med at vente på data.
KV-cachen er større, end de fleste tror. For en dense 70B-model som Llama i BF16-præcision vokser den med cirka 0,3 MB per token. En samtale med 8K kontekst kræver 2,5 GB alene til cachen, ved 32K kontekst er det 10 GB, og ved 128K fylder cachen alene 40 GB. Hvert token, du genererer, kræver, at hele denne cache læses fra hukommelsen.
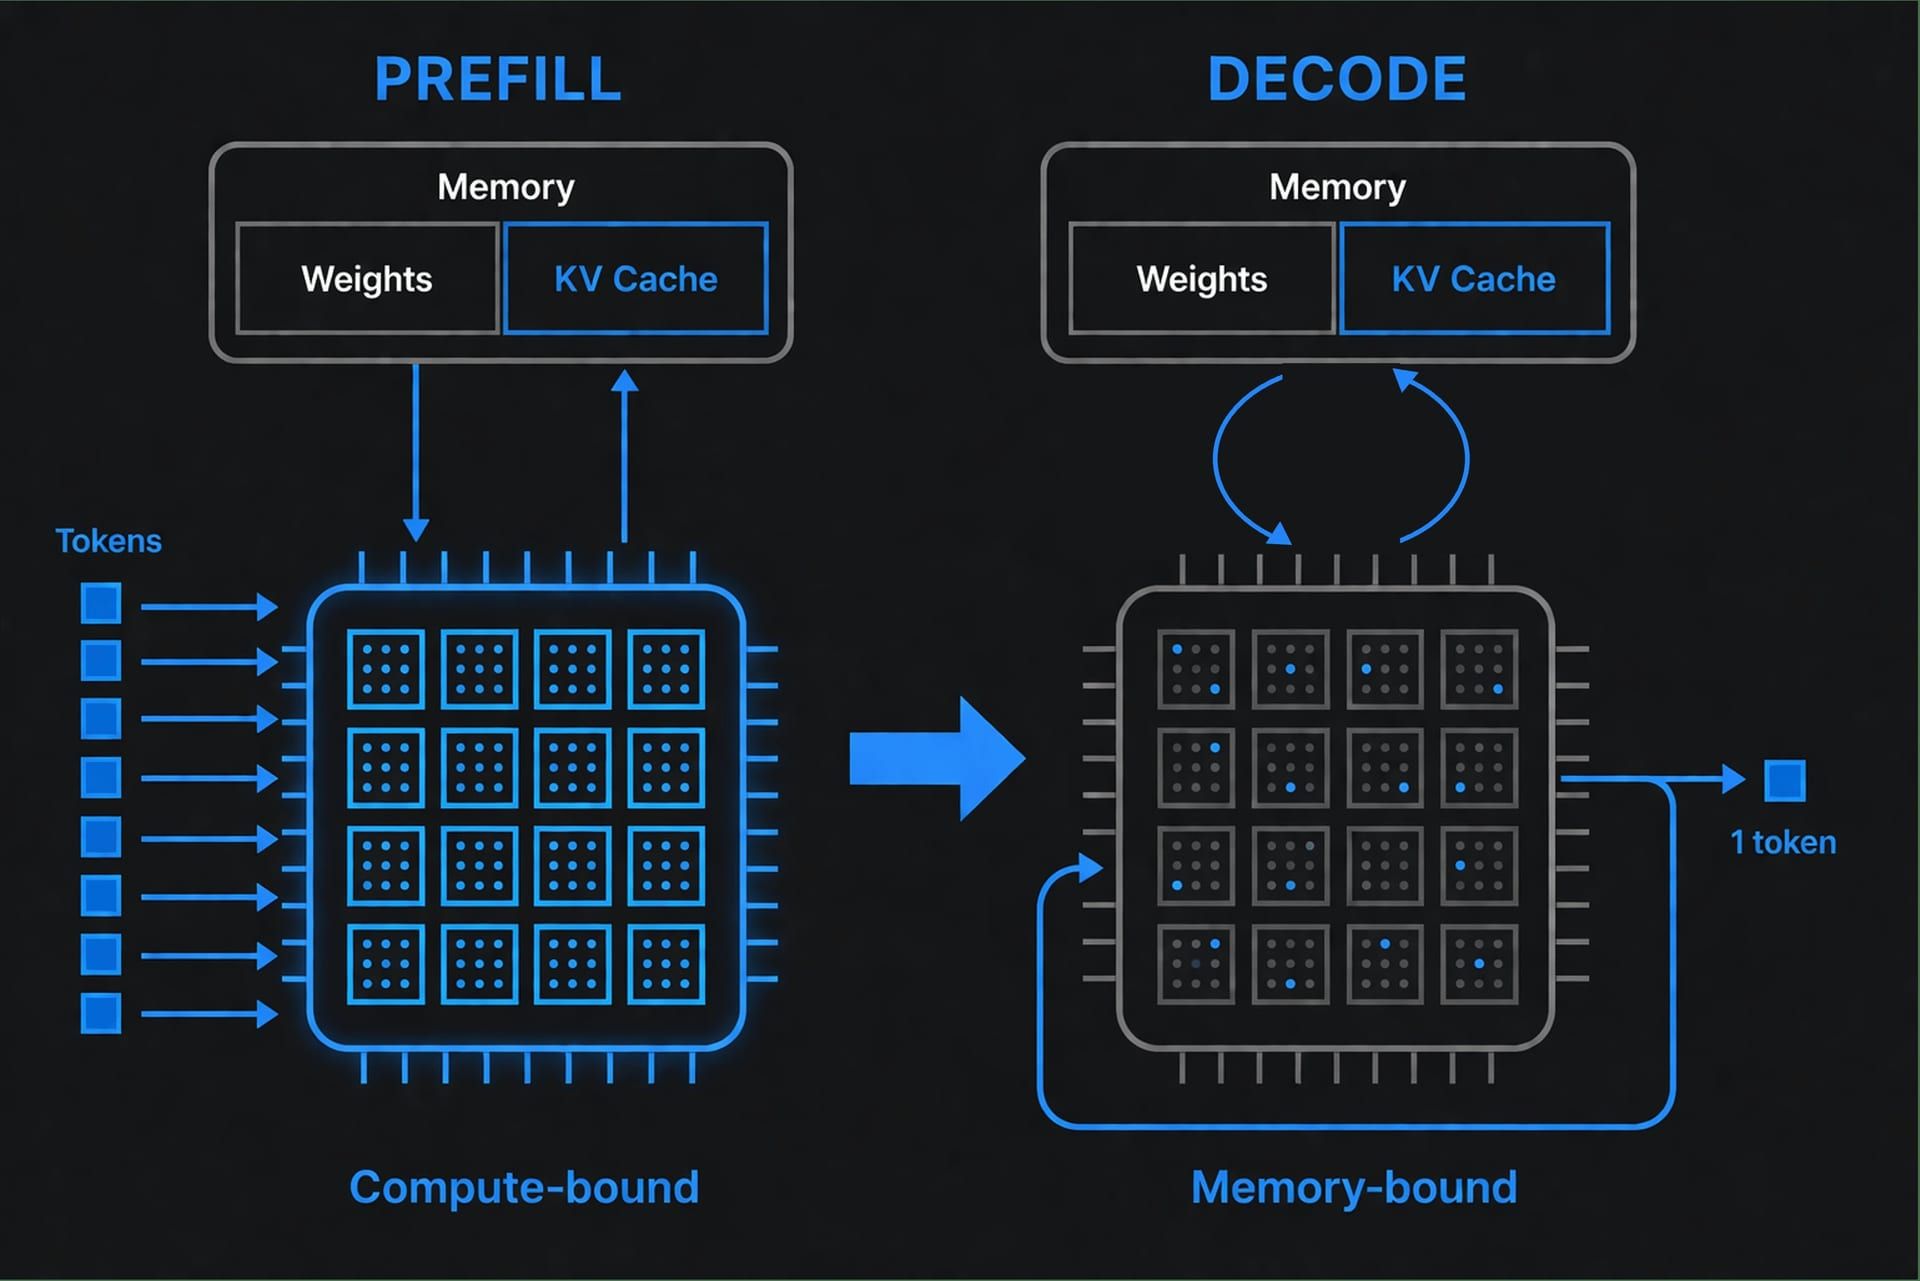
Under prefill ligger GPU-udnyttelsen på 80% eller mere. Under decode falder den til 20-40%. Regneenhederne står stille og venter på hukommelsen. Det er decode-flaskehalsen: ikke et softwareproblem, der kan optimeres væk, men et grundlæggende misforhold mellem GPU-arkitekturen og opgaven. GPU'er blev udviklet til grafik, altså massivt parallel matrixregning, som tilfældigvis også egner sig godt til at træne neurale netværk. Men inferens, især sekventiel generering af tokens, er et helt andet problem.
Læs mere i vores ordliste
Prefill vs. DecodeDataflow-arkitekturRDU (Reconfigurable Dataflow Unit)
Hvorfor hukommelsesbåndbredden begrænser inferens på GPU'er
For hvert output-token skal modellen læse de aktive vægte fra hukommelsen, læse hele KV-cachen, beregne forudsigelsen og opdatere cachen. For dense modeller betyder det, at alle parametre skal læses. For Mixture of Experts-modeller (MoE), som nu er den dominerende arkitektur, er kun en brøkdel aktiv per token: DeepSeek V4-Pro har 1,6T parametre i alt, men aktiverer kun 49B per token, hvilket reducerer læsningen af vægte markant. KV-cachen vokser dog stadig med kontekstlængden, uanset arkitekturen.
Lad os regne på en dense 70B-model for at se flaskehalsen tydeligt. Selve beregningen er triviel: 70B parametre betyder cirka 140 milliarder beregninger med flydende kommatal per token, og en H100-GPU leverer 2.000 TFLOPS. Regnestykket tager cirka 0,07 millisekunder.
Men at læse de 70B parametre fra hukommelsen tager meget længere tid. H100's HBM3-båndbredde er 3,35 TB/s. I FP16 fylder 70B parametre 140 GB, og det tager cirka 42 millisekunder at læse dem.
Derfor forudsiger rå TFLOPS ikke inferenshastigheden. Når udbydere viser dig GPU-specifikationer, viser de dig regnekraft. Men ved decode er hukommelsesbåndbredden flaskehalsen. Tal fra virkeligheden bekræfter det: GPU-inferens i produktion når typisk 50-150 tok/s på 70B-modeller. Den teoretiske regnekraft ville tillade over 14.000 tok/s. Forskellen er ventetid på hukommelsen.
Hvordan dataflow-arkitekturen ændrer regnestykket
Løsningen er ikke hurtigere GPU'er, men en anden arkitektur. Flere leverandører har bygget chips specielt til inferens: SambaNovas RDU (Reconfigurable Dataflow Unit), Groqs LPU (Language Processing Unit) og Cerebras' WSE (Wafer-Scale Engine). Hver af dem angriber hukommelsesflaskehalsen på sin egen måde.
Vi valgte SambaNovas dataflow-arkitektur til vores EU-infrastruktur (8 racks med 128 chips i München), fordi den håndterer store modeller effektivt uden at kræve hundredvis eller tusindvis af chips. Herefter forklarer vi, hvordan dataflow fungerer, og hvorfor det betyder noget for inferens.
Fire arkitektoniske forskelle forklarer, hvorfor dataflow slår GPU'er til inferens:
1. Samlebånd frem for værksted
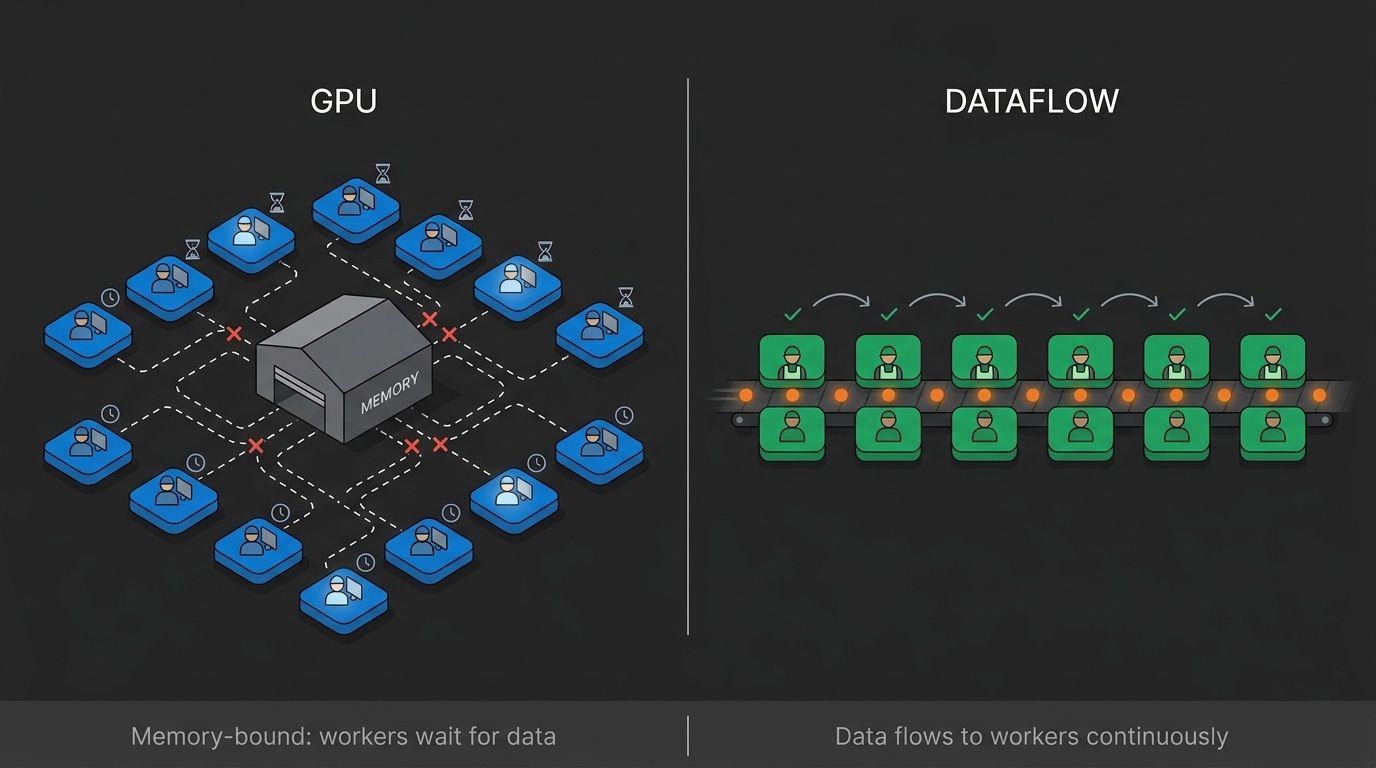
En GPU fungerer som et værksted med enkeltproduktion. Hver arbejder (regnekerne) tager en opgave, går på lageret (hukommelsen) efter materialer, udfører arbejdet, går tilbage for at lægge resultatet på plads og tager så den næste opgave. Der er tusindvis af arbejdere, men de bruger det meste af tiden på at gå frem og tilbage til lageret.
Dataflow-arkitekturen fungerer som et samlebånd. I stedet for at arbejderne går hen til materialerne, flyder materialerne forbi faste arbejdsstationer. Hver operation er fysisk placeret på chippen, og data strømmer fra den ene til den næste uden omveje via hukommelsen. Chippen er designet, så outputtet fra én operation allerede er på vej til den næste, når den første er færdig.
SambaNova kalder det "spatial execution": Beregningen afbildes på chippens fysiske layout i stedet for at blive planlagt som en række instruktioner. Resultatet er, at data bliver ved med at bevæge sig i stedet for at vente.
2. Tre lagringsniveauer, strategisk placeret
Hukommelsens hastighed afhænger af afstanden til processoren. Den nærmeste hukommelse (SRAM, direkte på chippen) er 100x hurtigere end det næste niveau (HBM), som stadig er langt hurtigere end systemhukommelsen (DDR). Kunsten er at have de rigtige data på det rigtige sted.
SambaNovas RDU bruger alle tre niveauer bevidst. SRAM på chippen håndterer de mest brugte data, altså mellemresultater, der ellers skulle til hukommelsen og tilbage. HBM (1 terabyte per rack) rummer modelvægtene og samtalecachen. DDR (12 terabyte per rack) rummer flere modeller og cachede prompts, så der kan skiftes med det samme.
Den afgørende forskel fra GPU'er er, at RDU'ens hukommelseshierarki styres af software og ikke af hardware. Compileren bestemmer, hvad der ligger hvor, i stedet for at forlade sig på cache-forudsigelser. For forudsigelige workloads som inferens, hvor man ved præcis, hvilke vægte der skal bruges i hvilken rækkefølge, fjerner det cache misses.
Det betyder også, at kvantisering ikke er nødvendig. GPU-udbydere komprimerer ofte modeller til INT8 eller INT4 for at mindske kravet til hukommelsesbåndbredde, og de bytter dermed nøjagtighed for hastighed. Dataflow-arkitekturens hukommelseshierarki løser båndbreddeproblemet direkte, så modellerne kører i deres oprindelige præcision uden kompromiser.
Designet gør det også muligt at køre meget store modeller på et enkelt rack. En model med 671B parametre kræver 40 racks (320 GPU'er), når den kører på GPU'er. SambaNova kører den på ét rack med 16 RDU'er, fordi hukommelseshierarkiet skalerer effektivt.
DDR-niveauet giver endnu en fordel: hurtige modelskift. Fordi DDR er forbundet direkte til chippene (og ikke tilgås via systemhukommelsen som på GPU'er), tager det millisekunder at indlæse en anden model i stedet for de sekunder eller minutter, det tager på GPU-infrastruktur. Et enkelt rack kan rumme flere modeller og skifte mellem dem efter behov.
3. Planlagt rute frem for GPS, der genberegner
GPU'er træffer beslutninger om scheduling under kørslen. Hardwaren jonglerer hele tiden med, hvilke tråde der kører hvor, håndterer konflikter, når flere kerner skal bruge de samme data, og koordinerer synkroniseringspunkter. Den fleksibilitet er værdifuld ved uforudsigelige workloads, men inferens er ikke uforudsigelig. Modelarkitekturen er kendt, og rækkefølgen af operationer er kendt. Den eneste variabel er inputdataene.
RDU'ens compiler udnytter den forudsigelighed. Den planlægger hele udførelsen på forhånd: hvilken chip der håndterer hvilket lag, hvornår data flyttes mellem chips, ja selv den præcise clockcyklus, hver operation starter i. Der er ingen beslutninger under kørslen, intet koordineringsoverhead og ingen venten på efternølere. Forskellen minder om den mellem et bud, der følger en GPS, som hele tiden genberegner ruten, og en lagerrobot hos Amazon, der kører en på forhånd optimeret rute gennem hallen. Når layoutet ikke ændrer sig, er planlægning bedre end improvisation.
4. Kontinuerlig pipeline frem for stop-and-go
Traditionel GPU-inferens kører som en række adskilte operationer: Attention-beregningen startes, systemet venter, til den er færdig, og skriver resultaterne til hukommelsen, så starter den næste operation og læser dem igen, og sådan fortsætter det. Hver overlevering mellem to operationer koster tid, ikke til beregning, men til skrivning til hukommelsen, kernel-opstarter og synkronisering. Ved en lang inferens, der genererer hundredvis af tokens, løber overleveringerne op.
Dataflow-udførelse smelter operationer sammen til kontinuerlige pipelines. Data flyder fra attention til feedforward og videre til næste lag uden at stoppe. Mellemresultater bliver på chippen i stedet for at tage turen til hukommelsen og tilbage. Udførelsen ligner mindre et stafetløb (aflevér stafetten, vent, løb) og mere en flod, der strømmer uafbrudt forbi en række behandlingsstationer.
Ydeevne målt i praksis
De arkitektoniske forskelle giver målbare hastighedsfordele. Artificial Analysis, der tester udbydere uafhængigt, måler konsekvent SambaNova blandt de hurtigste inferensudbydere: I deres live-benchmarks når gpt-oss-120b 685 tok/s og MiniMax M2.7 426 tok/s.
Hvordan ser det ud i sammenligning? GPU-baserede udbydere når typisk 50-150 tok/s på store modeller. Hastighedsforskellen på 3-10x afspejler direkte den arkitektoniske fordel, og forskellen vokser, jo større modellerne bliver, fordi hukommelsesbåndbredden så i endnu højere grad bliver flaskehalsen. Du kan læse mere om, hvad målingerne betyder, og hvornår hver af dem er vigtig, i LLM Inference-hastighed forklaret.
Decode-æraen: hvorfor det betyder noget nu
I årevis handlede samtaler om AI-infrastruktur om regnekraft: flere TFLOPS, større klynger, hurtigere træningskørsler. Det gav mening, så længe den største udfordring var at træne større modeller. Men inferens, især agentisk inferens, ændrer problemet fuldstændigt.
Agenter besvarer ikke kun én prompt og stopper så. De ræsonnerer over lange kontekster, genererer mange tokens, kalder værktøjer og prøver igen. Hver token-generering går gennem den samme decode-cyklus igen, og ineffektiv flytning af data lægger latens oveni token for token. Hurtigere tokens giver mere intelligens, fordi systemet kan udforske flere ræsonneringstrin inden for det samme tidsbudget. Derfor betyder hastighed så meget for agentic coding.
Energieffektivitet: en bivirkning af bedre arkitektur
Hurtigere inferens per watt er ikke kun et argument om bæredygtighed. Det påvirker driftsøkonomien direkte. Infercoms SambaNova-racks bruger hver omkring 10 kW. Tilsvarende GPU-infrastruktur bruger 40-50 kW eller mere per rack, altså fire til fem gange så meget strøm til en sammenlignelig inferenskapacitet. RDU'erne klarer sig desuden med almindelig luftkøling, mens GPU-installationer med høj tæthed ofte kræver væskekøling, der øger omkostninger og kompleksitet.
Stanfords Hazy Research-laboratorium har udviklet en metode til at måle "intelligens per watt", altså nyttigt output per energienhed. Målt på den måde leverer dataflow-arkitekturen op til 5x mere intelligens per joule end GPU-baseret inferens.
Effektiviteten kommer fra de samme arkitektoniske valg, som giver hastigheden. Når data holdes på chippen, falder trafikken til hukommelsen, og mindre hukommelsestrafik betyder mindre energi brugt på at flytte data. Statisk scheduling fjerner spildte cyklusser. Effekterne forstærker hinanden.
Det næste skridt: disaggregeret inferens
Branchen reagerer allerede. Den næste udvikling er i gang: disaggregeret inferens, hvor prefill og decode kører på helt separat hardware.
Logikken er ligetil. Prefill er compute-bound og har gavn af rå TFLOPS og høj parallelitet. Decode er memory-bound og har brug for båndbredde og hukommelsesadgang med lav latens. Kører begge faser på den samme chip, er én af dem altid suboptimal. Hvorfor gå på kompromis, når man kan specialisere?
På GTC 2026 annoncerede Jensen Huang, at NVIDIA bevæger sig mod disaggregeret inferens. SambaNova og Intel har annonceret en lignende arkitektur: GPU'er står for prefill (opbygning af KV-cachen), RDU'er for decode (hurtig generering af tokens), og Xeon-CPU'er styrer orkestrering og udførelse af værktøjer.
Det betyder endnu mere for agentiske workloads. Når en agent arbejder sig gennem en kompleks opgave, gentager den måske processen dusinvis af gange: Den ræsonnerer, kalder værktøjer, validerer resultater og starter forfra. Hver iteration rammer decode-fasen, og latensen hober sig op over iterationerne. En 3x hurtigere decode gør derfor ikke kun de enkelte svar hurtigere, men giver plads til flere ræsonneringstrin inden for det samme tidsbudget.
Det er ikke teori, for effektivitetsgevinsterne er for store til at blive ignoreret. Disaggregeret inferens vil sandsynligvis blive standard for højtydende installationer i de kommende år.
Konklusion
GPU-inferens rammer en mur på store modeller, fordi decode er memory-bound og ikke compute-bound. Chippen står stille og venter på data. Dataflow-arkitekturen løser det med spatial execution, lagdelt hukommelse, statisk scheduling og kontinuerlige pipelines. Resultatet er 3-10x hurtigere inferens på memory-bound workloads.
Decode-flaskehalsen forsvinder ikke. Tværtimod bliver den værre, i takt med at modellerne vokser, og agentiske workloads kræver flere tokens per opgave. Branchen reagerer med specialiseret hardware og disaggregerede arkitekturer. Infercom kører SambaNova, fordi det i dag giver den bedste kombination af hastighed, effektivitet og understøttelse af store modeller til drift i EU. Vi tilpasser os, efterhånden som hardwarelandskabet udvikler sig.
Du behøver ikke tage vores ord for det. På benchmark.infercom.ai kan du køre dine egne prompts mod vores infrastruktur. Artificial Analysis udgiver uafhængige benchmarks på tværs af udbydere. Test med dine typiske input- og outputlængder, og test i spidsbelastningstimerne. Arkitekturens fordele kan ses i tallene.
Mål selv efter, for kun sådan ved du det.
Yderligere kilder
Tekniske ressourcer fra SambaNova:
- Inference Speed or Throughput? With RDUs, You Don't Have to Choose
- The Decode Era of AI: Why Dataflow Matters More Than Ever
- Solving the Decode Bottleneck: Why Agentic Inference Needs Hybrid Hardware
Uafhængige analyser:
Ressourcer fra Infercom: