Solche Geschwindigkeitsangaben sagen aber wenig, solange man nicht versteht, woher sie kommen.
Wir sind hardwareunabhängig. Unsere Aufgabe ist es, Inferenz-Architekturen zu bewerten und für jeden Workload die beste Option einzusetzen. Für das speichergebundene Decode großer Modelle nutzen wir derzeit die Dataflow-Architektur von SambaNova, weil sie den Speicherengpass angeht, der die Inferenz auf GPUs begrenzt. Dieser Artikel erklärt die technischen Gründe für diese Wahl. Details zum Betrieb finden Sie in unserer Technologie-Übersicht.
Der Decode-Engpass
Um zu verstehen, warum manche Inferenz schneller ist als andere, hilft ein Blick darauf, was passiert, wenn Sie einen Prompt an ein LLM senden. Dabei laufen zwei getrennte Phasen ab, und sie belasten die Hardware auf völlig unterschiedliche Weise.
Prefill verarbeitet Ihren gesamten Prompt. Das Modell liest alle Token auf einmal und ermittelt, wie jedes Wort mit jedem anderen zusammenhängt, die sogenannte "Attention". Alle Input-Token werden parallel verarbeitet, und genau dafür wurden GPUs gebaut. Tausende Kerne sind beschäftigt, die Auslastung ist hoch, alles läuft wie vorgesehen. Im Prefill entsteht außerdem der KV-Cache, eine Speicherstruktur für Zwischenergebnisse der Attention, damit das Modell sie nicht für jedes neue Token neu berechnen muss.
Decode erzeugt die Output-Token eines nach dem anderen. Jedes neue Token hängt von allen vorherigen ab, die Arbeit ist also von Natur aus sequenziell. Für jedes Token muss das Modell die aktiven Gewichte aus dem Speicher lesen, den gesamten KV-Cache lesen, die Vorhersage berechnen und die Daten des neuen Tokens in den Cache schreiben. Die Berechnung selbst geht schnell im Vergleich zum Speicherzugriff, die meiste Zeit vergeht mit Warten auf Daten.
Der KV-Cache ist größer, als viele denken. Bei einem dichten 70B-Modell wie Llama in BF16-Präzision wächst er um etwa 0,3 MB pro Token. Ein Gespräch mit 8K Kontext braucht allein für den Cache 2,5 GB, bei 32K Kontext sind es 10 GB, bei 128K allein 40 GB. Und jedes erzeugte Token erfordert, diesen gesamten Cache aus dem Speicher zu lesen.
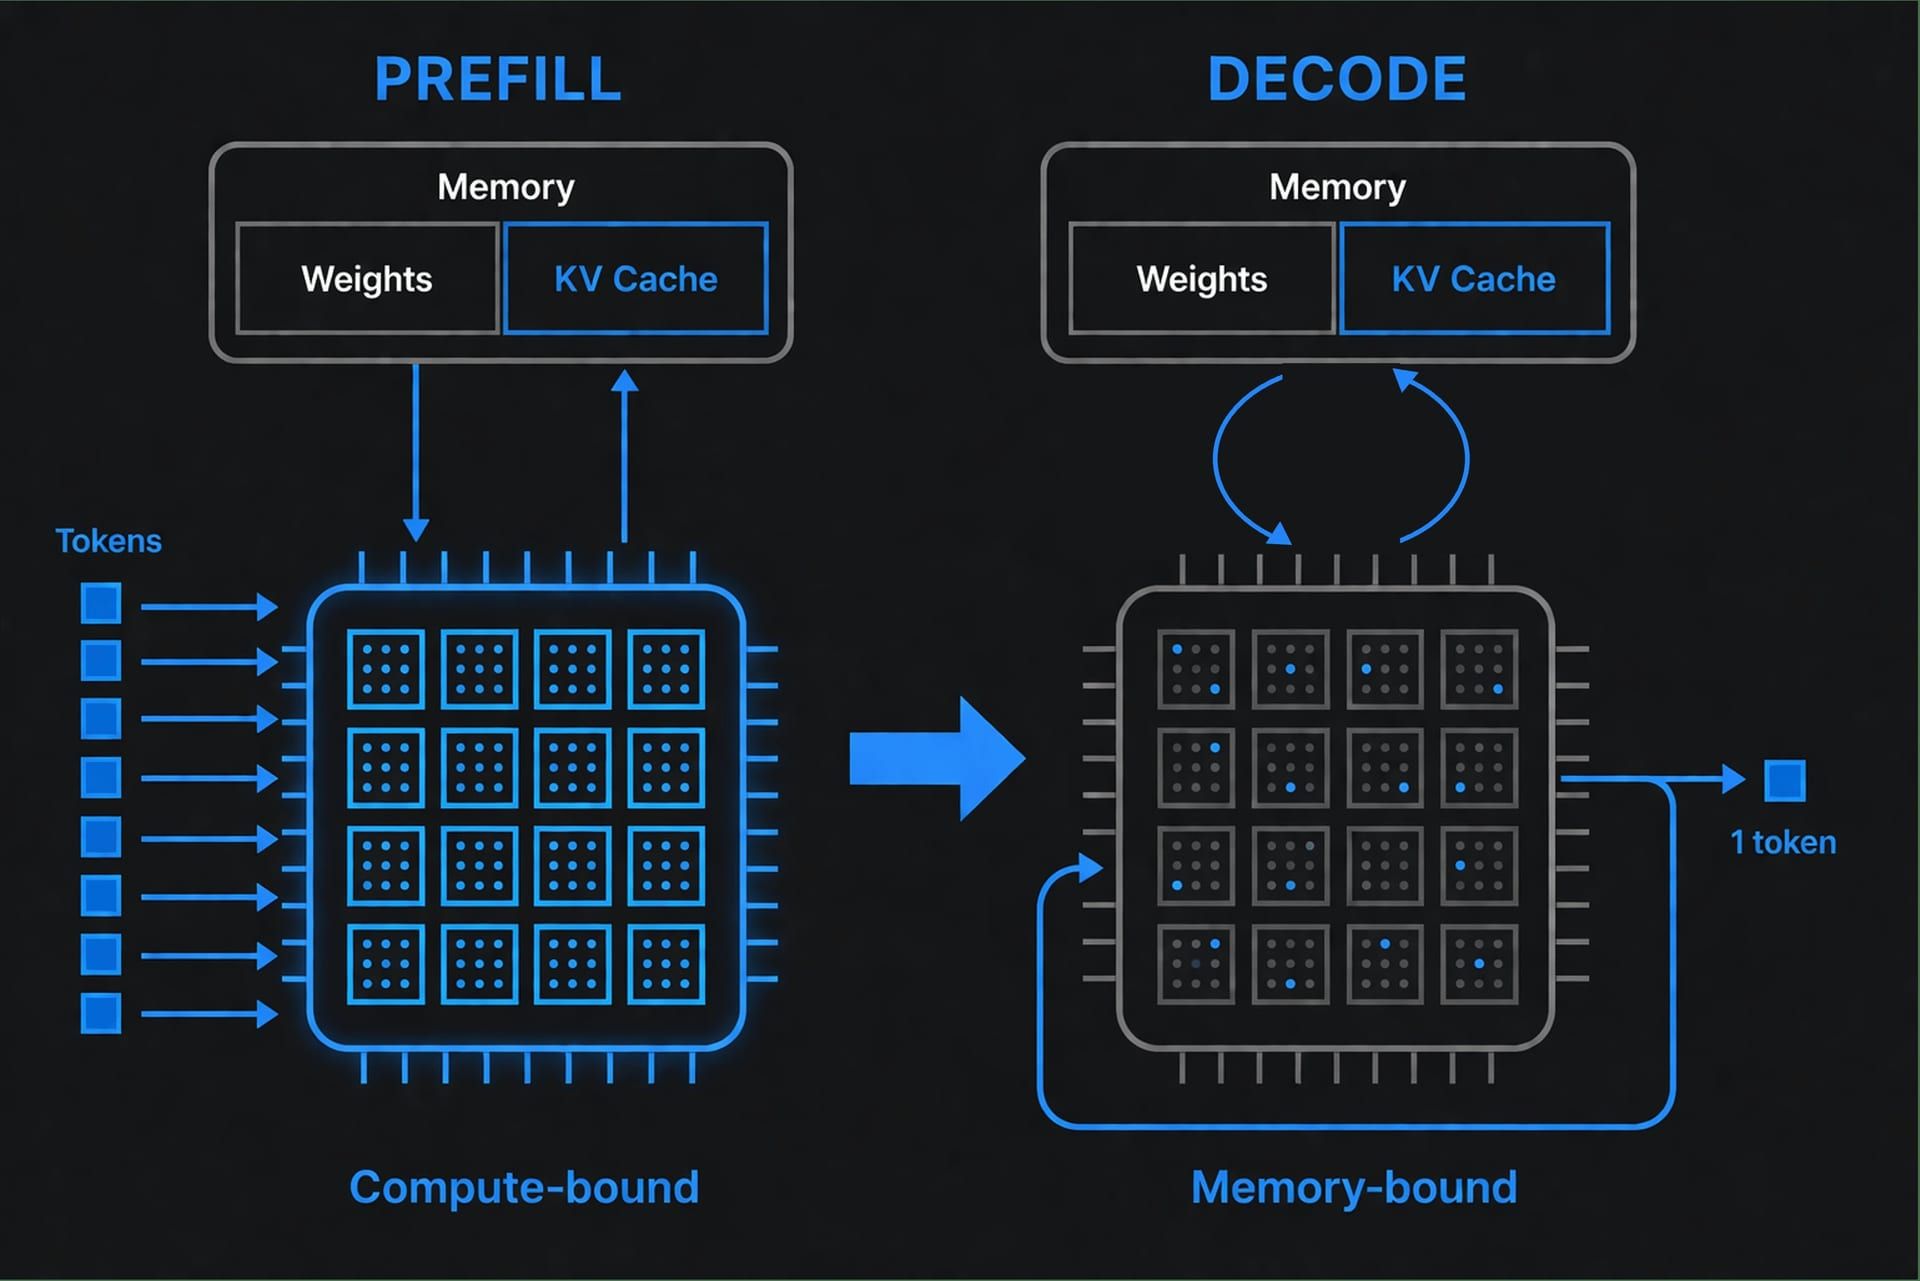
Im Prefill liegt die GPU-Auslastung bei 80% oder mehr. Im Decode sinkt sie auf 20-40%. Die Recheneinheiten stehen still und warten auf den Speicher. Das ist der Decode-Engpass: kein Softwareproblem, das sich wegoptimieren ließe, sondern ein grundlegendes Missverhältnis zwischen GPU-Architektur und Workload. GPUs wurden für das Grafikrendering entwickelt, also für massiv parallele Matrizenrechnung, die zufällig auch gut zum Training neuronaler Netze passt. Inferenz, vor allem die sequenzielle Erzeugung von Token, ist jedoch ein ganz anderes Problem.
Mehr dazu in unserem Glossar
Prefill vs. DecodeDataflow-ArchitekturRDU (Reconfigurable Dataflow Unit)
Warum die Speicherbandbreite die Inferenz auf GPUs begrenzt
Für jedes Output-Token muss das Modell die aktiven Gewichte aus dem Speicher lesen, den gesamten KV-Cache lesen, die Vorhersage berechnen und den Cache aktualisieren. Bei dichten Modellen heißt das, alle Parameter zu lesen. Bei Mixture-of-Experts-Modellen (MoE), inzwischen die vorherrschende Architektur, ist pro Token nur ein Bruchteil aktiv: DeepSeek V4-Pro hat insgesamt 1,6T Parameter, aktiviert aber nur 49B pro Token, was die Lesezugriffe auf die Gewichte stark verringert. Der KV-Cache wächst aber unabhängig von der Architektur mit der Kontextlänge.
Rechnen wir das für ein dichtes 70B-Modell durch, um den Engpass sichtbar zu machen. Die eigentliche Berechnung ist trivial: 70B Parameter bedeuten etwa 140 Milliarden Gleitkommaoperationen pro Token, und eine H100-GPU liefert 2000 TFLOPS. Die Rechnung dauert damit rund 0,07 Millisekunden.
Das Lesen dieser 70B Parameter aus dem Speicher dauert dagegen viel länger. Die HBM3-Bandbreite der H100 beträgt 3,35 TB/s. In FP16 entsprechen 70B Parameter 140 GB, und diese zu lesen dauert etwa 42 Millisekunden.
Deshalb sagen reine TFLOPS-Werte nichts über die Inferenz-Geschwindigkeit aus. Wenn Anbieter GPU-Datenblätter zeigen, zeigen sie Rechenleistung. Beim Decode ist aber die Speicherbandbreite der Engpass. Reale Zahlen bestätigen das: GPU-Inferenz in der Produktion erreicht bei 70B-Modellen typischerweise 50-150 tok/s. Theoretisch würde die Rechenleistung über 14.000 tok/s erlauben. Die Differenz ist Wartezeit auf den Speicher.
Wie die Dataflow-Architektur die Rechnung verändert
Die Lösung sind nicht schnellere GPUs, sondern eine andere Architektur. Mehrere Hersteller haben Chips eigens für Inferenz gebaut: die RDU von SambaNova (Reconfigurable Dataflow Unit), die LPU von Groq (Language Processing Unit) und die WSE von Cerebras (Wafer-Scale Engine). Jeder geht den Speicherengpass auf eine andere Weise an.
Für unsere EU-Infrastruktur (8 Racks mit 128 Chips in München) haben wir uns für die Dataflow-Architektur von SambaNova entschieden, weil sie große Modelle effizient verarbeitet, ohne Hunderte oder Tausende Chips zu benötigen. Im Folgenden erklären wir, wie Dataflow funktioniert und warum das für die Inferenz wichtig ist.
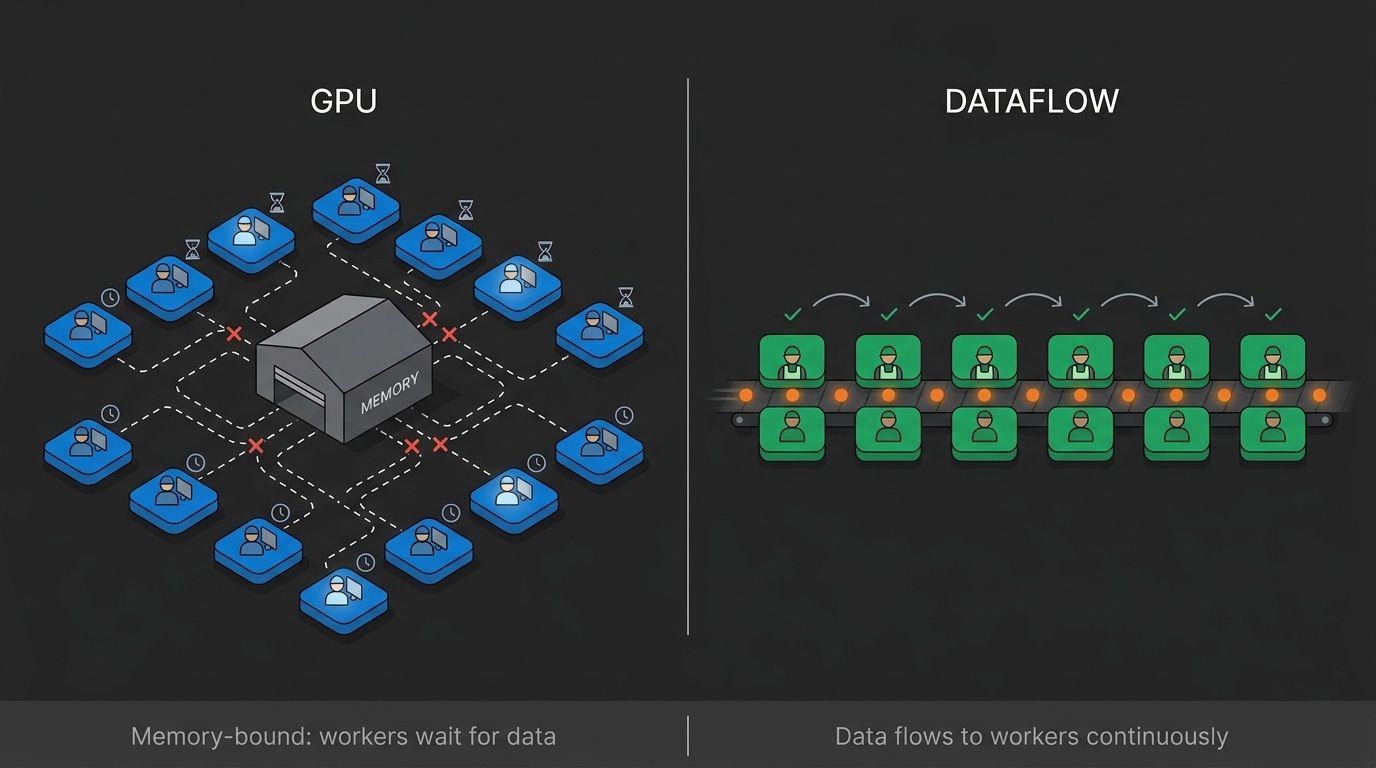
Vier architektonische Unterschiede erklären, warum Dataflow bei der Inferenz besser abschneidet als GPUs:
1. Fließband statt Werkstattfertigung
Eine GPU arbeitet wie eine Werkstatt mit Einzelfertigung. Jeder Arbeiter (Rechenkern) nimmt eine Aufgabe an, geht ins Lager (Speicher), um Material zu holen, erledigt die Arbeit, bringt das Ergebnis zurück ins Lager und nimmt dann die nächste Aufgabe an. Es gibt Tausende Arbeiter, doch sie verbringen die meiste Zeit auf dem Weg zum Lager und zurück.
Die Dataflow-Architektur arbeitet wie ein Fließband. Statt dass die Arbeiter zum Material gehen, fließt das Material an festen Arbeitsstationen vorbei. Jede Operation ist physisch auf dem Chip angeordnet, und die Daten strömen ohne Umweg über den Speicher von einer zur nächsten. Der Chip ist so ausgelegt, dass die Ausgabe einer Operation bereits bei der nächsten ankommt, sobald die erste fertig ist.
SambaNova nennt das "räumliche Ausführung" (spatial execution): Die Berechnung wird auf das physische Layout des Chips abgebildet, statt als Folge von Anweisungen abzulaufen. Das Ergebnis: Die Daten bleiben in Bewegung, statt zu warten.
2. Drei Speicherebenen, gezielt platziert
Wie schnell ein Speicher ist, hängt von seiner Entfernung zum Prozessor ab. Der nächstgelegene Speicher (SRAM, direkt auf dem Chip) ist 100x schneller als die nächste Ebene (HBM), und diese ist immer noch deutlich schneller als der Systemspeicher (DDR). Der Trick besteht darin, die richtigen Daten am richtigen Ort zu halten.
Die RDU von SambaNova nutzt alle drei Ebenen gezielt. Das SRAM auf dem Chip hält die heißesten Daten, also Zwischenergebnisse, die sonst zum Speicher und zurück wandern würden. Im HBM (1 Terabyte pro Rack) liegen die Modellgewichte und der Gesprächs-Cache. Das DDR (12 Terabyte pro Rack) hält mehrere Modelle und gecachte Prompts für einen sofortigen Wechsel bereit.
Der entscheidende Unterschied zu GPUs: Die Speicherhierarchie der RDU wird von der Software gesteuert, nicht von der Hardware. Der Compiler legt fest, was wo liegt, statt sich auf Cache-Vorhersagen zu verlassen. Bei vorhersehbaren Workloads wie der Inferenz, bei der feststeht, welche Gewichte in welcher Reihenfolge gebraucht werden, entfallen dadurch Cache-Misses.
Deshalb ist auch keine Quantisierung nötig. GPU-Anbieter komprimieren Modelle oft auf INT8 oder INT4, um den Bedarf an Speicherbandbreite zu senken, und tauschen dabei Genauigkeit gegen Geschwindigkeit. Die Dataflow-Speicherhierarchie löst das Bandbreitenproblem direkt, sodass Modelle ohne Abstriche in ihrer nativen Präzision laufen.
Dieses Design ermöglicht es außerdem, sehr große Modelle auf einem einzigen Rack zu betreiben. Ein Modell mit 671B Parametern braucht auf GPUs 40 Racks (320 GPUs). SambaNova betreibt es auf einem Rack mit 16 RDUs, weil die Speicherhierarchie effizient skaliert.
Die DDR-Ebene bringt einen weiteren Vorteil: schnelle Modellwechsel. Weil das DDR direkt an die Chips angebunden ist (und nicht wie bei GPUs über den Systemspeicher erreicht wird), dauert das Laden eines anderen Modells Millisekunden statt der Sekunden oder Minuten, die GPU-Infrastruktur braucht. Ein einziges Rack kann mehrere Modelle vorhalten und bei Bedarf zwischen ihnen wechseln.
3. Geplante Route statt Navi-Neuberechnung
GPUs treffen Scheduling-Entscheidungen zur Laufzeit. Die Hardware jongliert ständig damit, welche Threads wo laufen, löst Konflikte, wenn mehrere Kerne dieselben Daten brauchen, und koordiniert Synchronisationspunkte. Diese Flexibilität ist wertvoll für unvorhersehbare Workloads, doch Inferenz ist nicht unvorhersehbar. Die Modellarchitektur ist bekannt, die Abfolge der Operationen ebenfalls. Die einzige Variable sind die Eingabedaten.
Der RDU-Compiler nutzt diese Vorhersehbarkeit aus. Er plant die gesamte Ausführung im Voraus: welcher Chip welche Schicht übernimmt, wann Daten zwischen Chips wandern, sogar den genauen Taktzyklus, in dem jede Operation startet. Es gibt keine Entscheidungen zur Laufzeit, keinen Koordinationsaufwand und kein Warten auf Nachzügler. Der Unterschied ähnelt dem zwischen einem Lieferfahrer, der einem Navi folgt, das ständig neu berechnet, und einem Lagerroboter bei Amazon, der eine vorab optimierte Route durch die Halle fährt. Wenn sich das Layout nicht ändert, ist Planung besser als Improvisation.
4. Durchgehende Pipeline statt Stop-and-go
Klassische GPU-Inferenz läuft als Folge einzelner Operationen ab: Die Attention-Berechnung startet, das System wartet auf ihr Ende und schreibt die Ergebnisse in den Speicher, dann startet die nächste Operation und liest sie wieder aus, und so weiter. Jede Übergabe zwischen zwei Operationen kostet Zeit, nicht für die Berechnung, sondern für Schreibzugriffe, Kernel-Starts und Synchronisation. Bei einer langen Inferenz mit Hunderten erzeugten Token summieren sich diese Übergaben.
Dataflow-Ausführung verschmilzt Operationen zu durchgehenden Pipelines. Die Daten fließen ohne Halt von der Attention zum Feedforward und weiter zur nächsten Schicht. Zwischenergebnisse bleiben auf dem Chip, statt den Umweg über den Speicher zu nehmen. Die Ausführung ähnelt weniger einem Staffellauf (Stab übergeben, warten, laufen) als einem Fluss, der stetig an einer Reihe von Verarbeitungsstationen vorbeiströmt.
Reale Messwerte
Diese architektonischen Unterschiede führen zu messbaren Geschwindigkeitsvorteilen. Artificial Analysis testet Anbieter unabhängig und misst SambaNova durchgehend unter den schnellsten Inferenz-Anbietern: In den Live-Benchmarks erreicht gpt-oss-120b 685 tok/s und MiniMax M2.7 426 tok/s.
Wie ordnet sich das ein? GPU-basierte Anbieter erreichen bei großen Modellen typischerweise 50-150 tok/s. Der Geschwindigkeitsunterschied von 3-10x spiegelt direkt den architektonischen Vorteil wider, und die Lücke wächst mit der Modellgröße, weil die Speicherbandbreite dann noch stärker zum Engpass wird. Was diese Metriken bedeuten und wann welche zählt, erklärt der Artikel LLM Inference-Geschwindigkeit erklärt.
Die Decode-Ära: Warum das gerade jetzt wichtig ist
Jahrelang ging es in Gesprächen über KI-Infrastruktur um Rechenleistung: mehr TFLOPS, größere Cluster, schnellere Trainingsläufe. Das war sinnvoll, solange die größte Herausforderung darin bestand, immer größere Modelle zu trainieren. Die Inferenz, vor allem agentische Inferenz, verändert das Problem jedoch grundlegend.
Agenten beantworten nicht nur einen Prompt und hören dann auf. Sie denken über lange Kontexte hinweg nach, erzeugen viele Token, rufen Tools auf und setzen immer wieder neu an. Jedes erzeugte Token durchläuft erneut denselben Decode-Zyklus, und ineffiziente Datenbewegung summiert die Latenz Token für Token. Schnellere Token bedeuten mehr Intelligenz, weil das System im selben Zeitbudget mehr Denkschritte ausprobieren kann. Deshalb ist Geschwindigkeit beim Agentic Coding so wichtig.
Energieeffizienz: ein Nebeneffekt der besseren Architektur
Mehr Inferenz pro Watt ist nicht nur ein Nachhaltigkeitsargument, sondern wirkt sich direkt auf die Betriebskosten aus. Die SambaNova-Racks von Infercom verbrauchen jeweils rund 10 kW. Vergleichbare GPU-Infrastruktur braucht 40-50 kW oder mehr pro Rack, also das Vier- bis Fünffache an Strom für eine ähnliche Inferenzkapazität. Die RDUs kommen außerdem mit normaler Luftkühlung aus, während GPU-Installationen mit hoher Dichte oft eine Flüssigkühlung brauchen, die Kosten und Komplexität erhöht.
Das Hazy Research Lab der Stanford University hat eine Methode zur Messung von "Intelligenz pro Watt" entwickelt, also des nützlichen Outputs pro verbrauchter Energieeinheit. Nach dieser Metrik liefert die Dataflow-Architektur bis zu 5x mehr Intelligenz pro Joule als GPU-basierte Inferenz.
Diese Effizienz entsteht aus denselben architektonischen Entscheidungen, die auch die Geschwindigkeit ermöglichen. Daten auf dem Chip zu halten, verringert den Speicherverkehr, und weniger Speicherverkehr bedeutet weniger Energie für Datenbewegung. Statisches Scheduling vermeidet verschwendete Zyklen. Diese Effekte verstärken sich gegenseitig.
Was als Nächstes kommt: disaggregierte Inferenz
Die Branche reagiert bereits. Der nächste Entwicklungsschritt ist schon im Gange: disaggregierte Inferenz, bei der Prefill und Decode auf völlig getrennter Hardware laufen.
Die Logik ist einleuchtend. Prefill ist rechengebunden und profitiert von reinen TFLOPS und viel Parallelität. Decode ist speichergebunden und braucht Bandbreite und Speicherzugriffe mit geringer Latenz. Laufen beide Phasen auf demselben Chip, ist eine davon immer im Nachteil. Warum also Kompromisse eingehen, wenn man spezialisieren kann?
Auf der GTC 2026 kündigte Jensen Huang an, dass NVIDIA sich in Richtung disaggregierter Inferenz bewegt. SambaNova und Intel haben eine ähnliche Architektur angekündigt: GPUs übernehmen das Prefill (den Aufbau des KV-Cache), RDUs das Decode (die schnelle Erzeugung der Token), und Xeon-CPUs kümmern sich um die Orchestrierung und die Ausführung von Tools.
Für agentische Workloads zählt das noch mehr. Wenn ein Agent eine komplexe Aufgabe durchdenkt, iteriert er womöglich Dutzende Male: Er denkt nach, ruft Tools auf, prüft Ergebnisse und beginnt von vorn. Jede Iteration durchläuft die Decode-Phase, und die Latenz summiert sich über alle Iterationen. Ein 3x schnelleres Decode macht deshalb nicht nur einzelne Antworten schneller, sondern ermöglicht mehr Denkschritte im selben Zeitbudget.
Das ist keine Theorie, dafür sind die Effizienzgewinne zu groß. Disaggregierte Inferenz dürfte sich in den kommenden Jahren zum Standard für Hochleistungs-Deployments entwickeln.
Das Fazit
GPU-Inferenz stößt bei großen Modellen an eine Grenze, weil das Decode speichergebunden ist und nicht rechengebunden. Der Chip steht still und wartet auf Daten. Die Dataflow-Architektur löst dieses Problem mit räumlicher Ausführung, gestaffeltem Speicher, statischem Scheduling und durchgehenden Pipelines. Das Ergebnis ist eine 3-10x schnellere Inferenz bei speichergebundenen Workloads.
Der Decode-Engpass verschwindet nicht. Im Gegenteil, er verschärft sich, weil die Modelle wachsen und agentische Workloads mehr Token pro Aufgabe verlangen. Die Branche reagiert mit spezialisierter Hardware und disaggregierten Architekturen. Infercom setzt auf SambaNova, weil diese Architektur heute die beste Kombination aus Geschwindigkeit, Effizienz und Unterstützung großer Modelle für den Betrieb in der EU bietet. Wenn sich die Hardware-Landschaft weiterentwickelt, passen wir uns an.
Sie müssen uns das nicht glauben. Auf benchmark.infercom.ai testen Sie Ihre eigenen Prompts auf unserer Infrastruktur. Artificial Analysis veröffentlicht unabhängige Benchmarks über viele Anbieter hinweg. Testen Sie mit Ihren typischen Input- und Output-Längen, und testen Sie zu Spitzenzeiten. Die Vorteile der Architektur zeigen sich in den Zahlen.
Messen Sie selbst nach. Nur so wissen Sie es.
Weiterführende Quellen
Technische Ressourcen von SambaNova:
- Inference Speed or Throughput? With RDUs, You Don't Have to Choose
- The Decode Era of AI: Why Dataflow Matters More Than Ever
- Solving the Decode Bottleneck: Why Agentic Inference Needs Hybrid Hardware
Unabhängige Analysen:
Ressourcen von Infercom: