Ma i dati sulla velocità dicono poco se non si capisce da dove vengono.
Siamo indipendenti dall'hardware. Il nostro lavoro è valutare le architetture di inferenza e adottare l'opzione migliore per ogni workload. Per il decode memory-bound sui modelli grandi oggi usiamo l'architettura dataflow di SambaNova, perché affronta il collo di bottiglia della memoria che limita l'inferenza su GPU. Questo articolo spiega le ragioni tecniche di questa scelta. I dettagli sul deployment sono nella nostra panoramica tecnologica.
Il collo di bottiglia del decode
Per capire perché un'inferenza è più veloce di un'altra, bisogna guardare cosa succede quando invii un prompt a un LLM. Si susseguono due fasi distinte, e mettono sotto sforzo l'hardware in modi completamente diversi.
Il prefill elabora l'intero prompt. Il modello legge tutti i token insieme e calcola come ogni parola si relaziona con tutte le altre, la cosiddetta "attention". Tutti i token di input vengono elaborati in parallelo, ed è proprio il lavoro per cui sono nate le GPU. Migliaia di core restano occupati, l'utilizzo è alto, tutto funziona come previsto. Il prefill costruisce anche la KV cache, una struttura di memoria che conserva i calcoli intermedi dell'attention, così il modello non deve ricalcolarli per ogni nuovo token.
Il decode genera i token di output uno alla volta. Ogni nuovo token dipende da tutti i precedenti, quindi il lavoro è sequenziale per natura. Per ogni token il modello deve leggere dalla memoria i pesi attivi, leggere l'intera KV cache, calcolare la previsione e aggiungere alla cache i dati del nuovo token. Il calcolo è veloce rispetto all'accesso alla memoria: la maggior parte del tempo se ne va ad aspettare i dati.
La KV cache è più grande di quanto molti pensino. Per un modello dense da 70B come Llama in precisione BF16 cresce di circa 0,3 MB per token. Una conversazione con 8K di contesto richiede 2,5 GB solo per la cache, a 32K di contesto sono 10 GB, a 128K la cache da sola arriva a 40 GB. Ogni token che generi richiede di leggere dalla memoria l'intera cache.
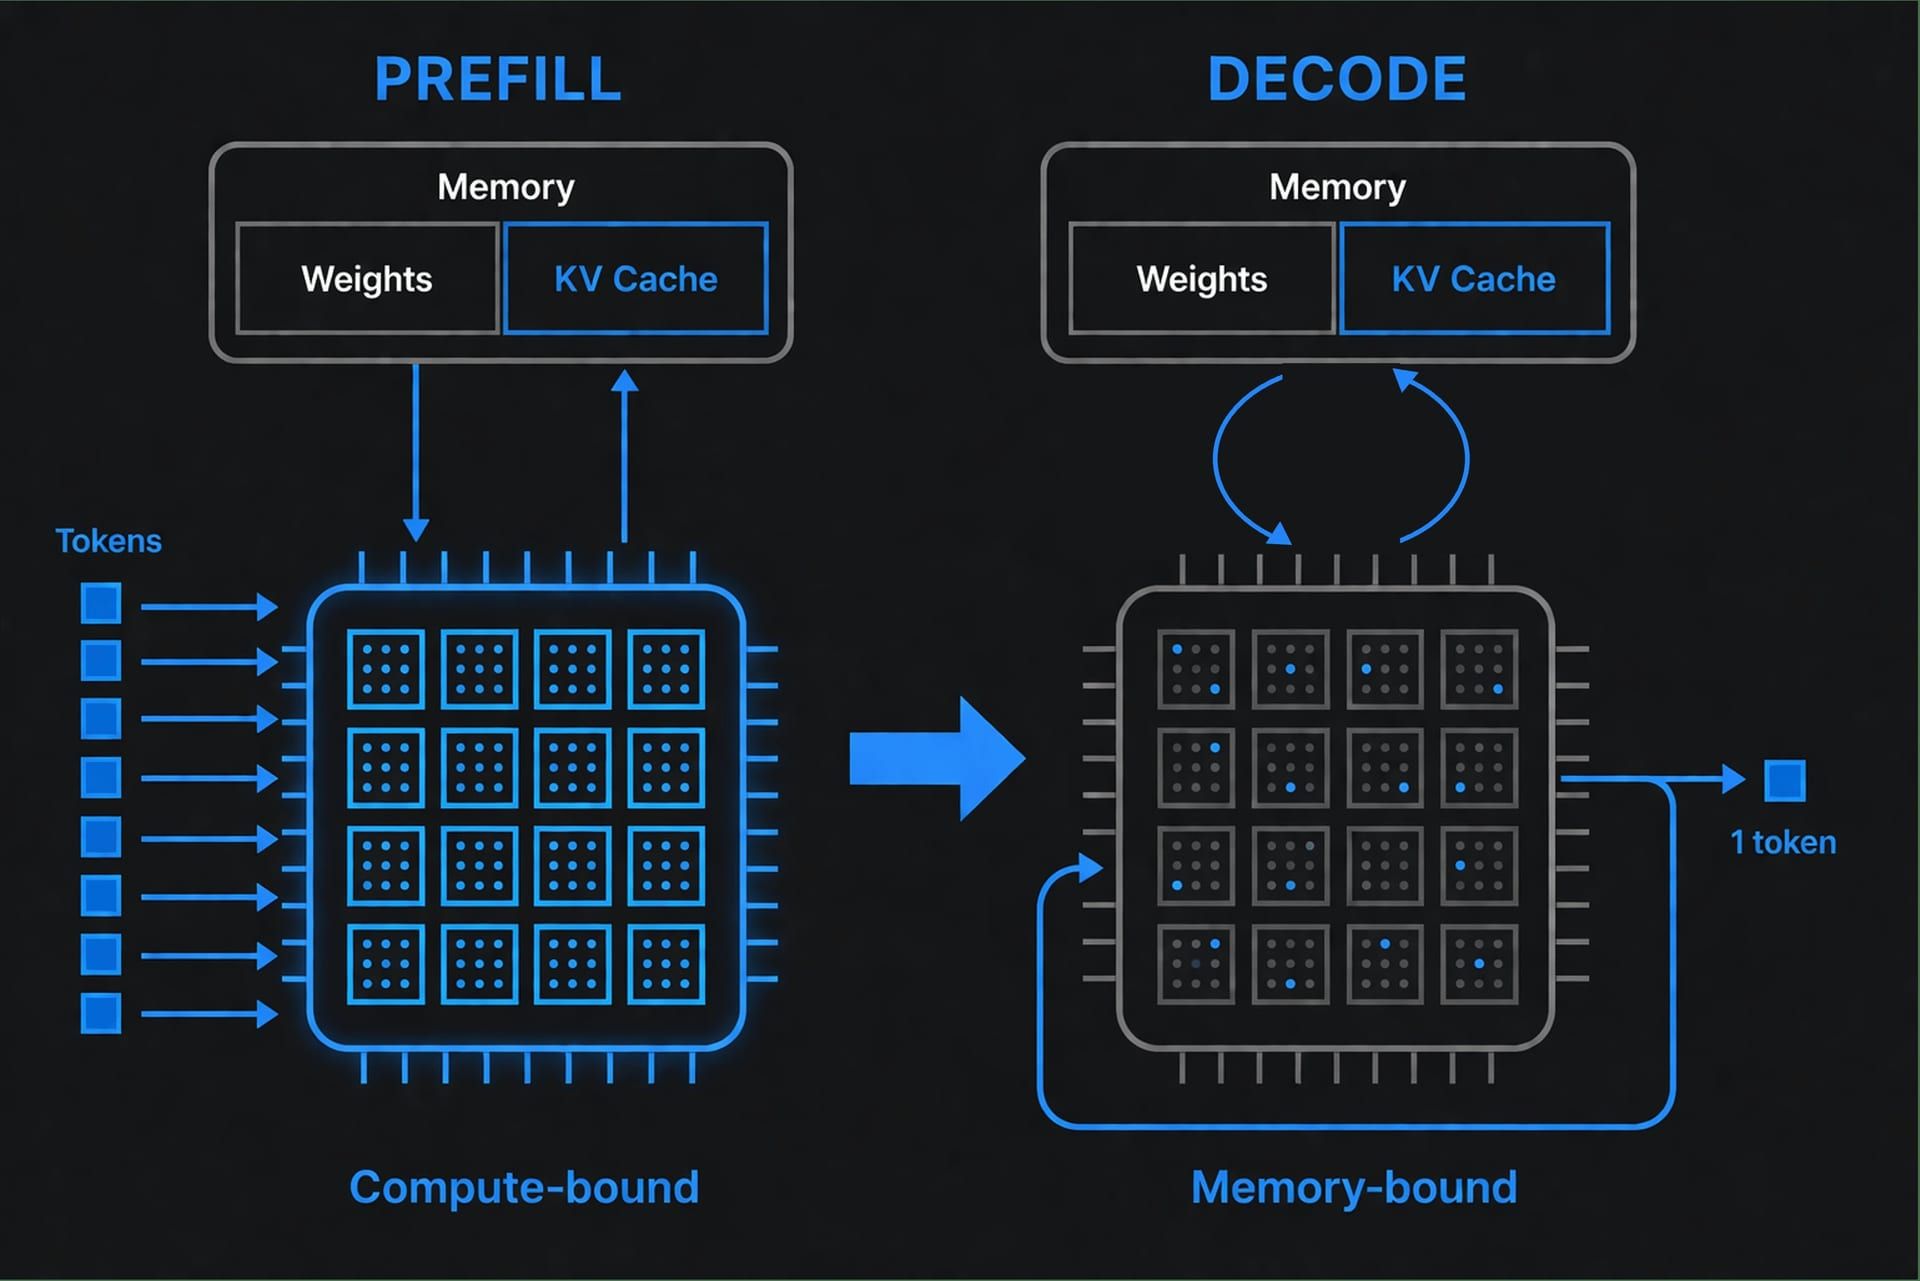
Durante il prefill l'utilizzo della GPU è dell'80% o più. Durante il decode scende al 20-40%. Le unità di calcolo restano ferme in attesa della memoria. È questo il collo di bottiglia del decode: non un problema software da ottimizzare, ma un disallineamento di fondo tra l'architettura della GPU e il carico di lavoro. Le GPU sono nate per la grafica, cioè per calcoli matriciali massivamente paralleli che si sono rivelati adatti anche all'addestramento delle reti neurali. Ma l'inferenza, e in particolare la generazione sequenziale di token, è un problema completamente diverso.
Approfondimenti nel nostro glossario
Prefill vs. DecodeArchitettura dataflowRDU (Reconfigurable Dataflow Unit)
Perché la banda di memoria limita l'inferenza su GPU
Per ogni token di output il modello deve leggere dalla memoria i pesi attivi, leggere l'intera KV cache, calcolare la previsione e aggiornare la cache. Per i modelli dense significa leggere tutti i parametri. Nei modelli Mixture of Experts (MoE), oggi l'architettura dominante, per ogni token se ne attiva solo una frazione: DeepSeek V4-Pro ha 1,6T parametri totali ma ne attiva solo 49B per token, il che riduce drasticamente le letture dei pesi. La KV cache però continua a crescere con la lunghezza del contesto, qualunque sia l'architettura.
Facciamo i conti su un modello dense da 70B per vedere chiaramente il collo di bottiglia. Il calcolo vero e proprio è banale: 70B parametri significano circa 140 miliardi di operazioni in virgola mobile per token, e una GPU H100 offre 2.000 TFLOPS. Il calcolo richiede circa 0,07 millisecondi.
Leggere quei 70B parametri dalla memoria, invece, richiede molto più tempo. La banda HBM3 della H100 è di 3,35 TB/s. In FP16, 70B parametri occupano 140 GB, e leggerli richiede circa 42 millisecondi.
Per questo i TFLOPS da soli non predicono la velocità di inferenza. Quando i provider mostrano le specifiche delle GPU, mostrano la potenza di calcolo. Ma nel decode il collo di bottiglia è la banda di memoria. I numeri reali lo confermano: l'inferenza su GPU in produzione raggiunge di solito 50-150 tok/s sui modelli da 70B. La potenza di calcolo teorica permetterebbe oltre 14.000 tok/s. La differenza è tempo speso ad aspettare la memoria.
Come l'architettura dataflow cambia i conti
La soluzione non sono GPU più veloci, ma un'architettura diversa. Diversi produttori hanno costruito chip pensati apposta per l'inferenza: l'RDU di SambaNova (Reconfigurable Dataflow Unit), l'LPU di Groq (Language Processing Unit) e il WSE di Cerebras (Wafer-Scale Engine). Ognuno affronta il collo di bottiglia della memoria in modo diverso.
Per la nostra infrastruttura UE (8 rack con 128 chip a Monaco) abbiamo scelto l'architettura dataflow di SambaNova, perché gestisce i modelli grandi in modo efficiente senza richiedere centinaia o migliaia di chip. Di seguito spieghiamo come funziona il dataflow e perché conta per l'inferenza.
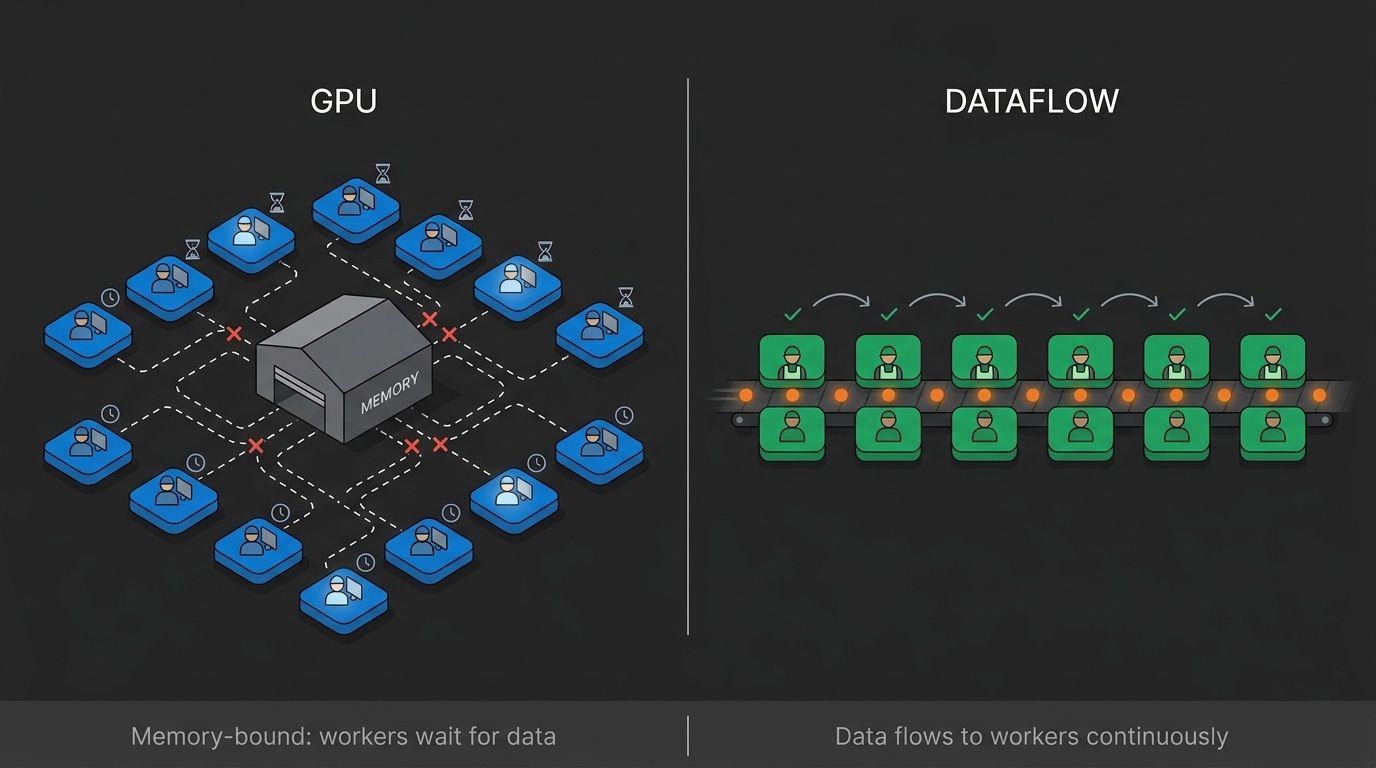
Quattro differenze architetturali spiegano perché il dataflow batte le GPU nell'inferenza:
1. Catena di montaggio contro officina
Una GPU funziona come un'officina artigianale. Ogni operaio (core di calcolo) prende un compito, va in magazzino (la memoria) a prendere i materiali, fa il lavoro, torna indietro a depositare il risultato e poi prende il compito successivo. Gli operai sono migliaia, ma passano gran parte del tempo ad andare avanti e indietro dal magazzino.
L'architettura dataflow funziona come una catena di montaggio. Invece di spostare gli operai verso i materiali, sono i materiali a scorrere tra postazioni fisse. Ogni operazione è disposta fisicamente sul chip, e i dati passano dall'una all'altra senza deviazioni verso la memoria. Il chip è progettato in modo che, quando un'operazione finisce, il suo output stia già arrivando a quella successiva.
SambaNova la chiama "spatial execution": il calcolo viene mappato sul layout fisico del chip invece di essere pianificato come una sequenza di istruzioni. Il risultato è che i dati continuano a muoversi invece di aspettare.
2. Tre livelli di memoria, posizionati con criterio
La velocità della memoria dipende dalla distanza dal processore. La memoria più vicina (SRAM, sul chip stesso) è 100x più veloce del livello successivo (HBM), che a sua volta è molto più veloce della memoria di sistema (DDR). Il trucco sta nel tenere i dati giusti nel posto giusto.
L'RDU di SambaNova usa deliberatamente tutti e tre i livelli. La SRAM sul chip gestisce i dati più usati, cioè i calcoli intermedi che altrimenti farebbero la spola con la memoria. La HBM (1 terabyte per rack) contiene i pesi del modello e la cache della conversazione. La DDR (12 terabyte per rack) conserva più modelli e prompt in cache per passare dall'uno all'altro all'istante.
La differenza chiave rispetto alle GPU è che la gerarchia di memoria dell'RDU è controllata dal software, non gestita dall'hardware. È il compilatore a decidere cosa va dove, invece di affidarsi alla previsione della cache. Per carichi prevedibili come l'inferenza, dove si sa con precisione quali pesi servono e in quale ordine, questo elimina i cache miss.
Questo significa anche che la quantizzazione non serve. I provider su GPU comprimono spesso i modelli in INT8 o INT4 per ridurre il fabbisogno di banda di memoria, scambiando accuratezza con velocità. La gerarchia di memoria del dataflow risolve direttamente il problema della banda, così i modelli girano nella loro precisione nativa senza compromessi.
Questo design permette anche di far girare modelli enormi su un solo rack. Un modello da 671B parametri richiede 40 rack (320 GPU) se gira su GPU. SambaNova lo fa girare su un solo rack con 16 RDU, perché la gerarchia di memoria scala in modo efficiente.
Il livello DDR offre un altro vantaggio: il cambio rapido di modello. Poiché la DDR è collegata direttamente ai chip (e non raggiunta tramite la memoria di sistema come sulle GPU), caricare un altro modello richiede millisecondi invece dei secondi o minuti necessari su un'infrastruttura GPU. Un singolo rack può ospitare più modelli e passare dall'uno all'altro su richiesta.
3. Percorso pianificato contro navigatore che ricalcola
Le GPU prendono le decisioni di scheduling durante l'esecuzione. L'hardware si destreggia di continuo tra quali thread girano dove, gestisce i conflitti quando più core hanno bisogno degli stessi dati e coordina i punti di sincronizzazione. Questa flessibilità è preziosa per carichi imprevedibili, ma l'inferenza non è imprevedibile. L'architettura del modello è nota, e anche la sequenza delle operazioni. L'unica variabile sono i dati in ingresso.
Il compilatore dell'RDU sfrutta questa prevedibilità. Pianifica in anticipo l'intera esecuzione: quale chip gestisce quale layer, quando i dati si spostano tra i chip, perfino il ciclo di clock esatto in cui parte ogni operazione. Non ci sono decisioni a runtime, né overhead di coordinamento, né attese per i ritardatari. È la differenza tra un corriere che segue un navigatore che ricalcola di continuo il percorso e un robot di magazzino di Amazon che segue un percorso ottimizzato in anticipo. Quando il layout non cambia, la pianificazione batte l'improvvisazione.
4. Pipeline continua contro stop-and-go
L'inferenza tradizionale su GPU procede come una serie di operazioni separate: si avvia il calcolo dell'attention, si aspetta che finisca, si scrivono i risultati in memoria, si avvia l'operazione successiva, si rileggono i risultati dalla memoria, e così via. Ogni passaggio tra un'operazione e l'altra costa tempo, non per il calcolo, ma per le scritture in memoria, l'avvio dei kernel e la sincronizzazione. In un'inferenza lunga che genera centinaia di token, questi passaggi si sommano.
L'esecuzione dataflow fonde le operazioni in pipeline continue. I dati passano dall'attention al feedforward e al layer successivo senza fermarsi. I risultati intermedi restano sul chip invece di fare avanti e indietro con la memoria. L'esecuzione somiglia meno a una staffetta (passa il testimone, aspetta, corri) e più a un fiume, che scorre senza sosta attraverso una serie di stazioni di lavorazione.
Numeri reali sulle prestazioni
Queste differenze architetturali si traducono in vantaggi di velocità misurabili. Artificial Analysis, che testa i provider in modo indipendente, colloca costantemente SambaNova tra i provider di inferenza più veloci: nei suoi benchmark live gpt-oss-120b raggiunge 685 tok/s e MiniMax M2.7 426 tok/s.
Come si confronta? I provider basati su GPU raggiungono di solito 50-150 tok/s sui modelli grandi. La differenza di velocità di 3-10x riflette direttamente il vantaggio architetturale, e il divario cresce con la dimensione dei modelli, perché la banda di memoria diventa un collo di bottiglia ancora più stretto. Per capire cosa significano queste metriche e quando conta ciascuna, leggi Velocità di inferenza LLM spiegata.
L'era del decode: perché conta proprio adesso
Per anni le discussioni sull'infrastruttura AI si sono concentrate sulla potenza di calcolo: più TFLOPS, cluster più grandi, addestramenti più veloci. Aveva senso finché la sfida principale era addestrare modelli sempre più grandi. Ma l'inferenza, e in particolare l'inferenza agentica, cambia del tutto il problema.
Gli agenti non si limitano a rispondere a un prompt e fermarsi. Ragionano su contesti lunghi, generano molti token, chiamano strumenti e riprovano. Ogni token generato rientra nello stesso ciclo di decode, e uno spostamento inefficiente dei dati accumula latenza token dopo token. Token più veloci si traducono in più intelligenza, perché il sistema può esplorare più passaggi di ragionamento nello stesso tempo a disposizione. Ecco perché la velocità conta così tanto nell'agentic coding.
Efficienza energetica: un effetto collaterale di un'architettura migliore
Un'inferenza più veloce per watt non è solo un argomento di sostenibilità: incide direttamente sui costi operativi. I rack SambaNova di Infercom assorbono circa 10 kW ciascuno. Un'infrastruttura GPU equivalente arriva a 40-50 kW o più per rack, cioè da quattro a cinque volte l'energia per una capacità di inferenza paragonabile. Le RDU usano inoltre un normale raffreddamento ad aria, mentre le installazioni GPU ad alta densità richiedono spesso un raffreddamento a liquido che aggiunge costi e complessità.
L'Hazy Research lab di Stanford ha sviluppato una metodologia per misurare l'"intelligenza per watt", cioè l'output utile per unità di energia consumata. Con questa metrica, l'architettura dataflow offre fino a 5x più intelligenza per joule rispetto all'inferenza basata su GPU.
Questa efficienza nasce dalle stesse scelte architetturali che rendono possibile la velocità. Tenere i dati sul chip riduce il traffico verso la memoria, e meno traffico significa meno energia spesa per spostare dati. Lo scheduling statico elimina i cicli sprecati. Gli effetti si sommano.
Il passo successivo: l'inferenza disaggregata
Il settore sta reagendo. La prossima evoluzione è già in corso: l'inferenza disaggregata, in cui prefill e decode girano su hardware completamente separato.
La logica è semplice. Il prefill è compute-bound e trae vantaggio da molti TFLOPS e da un alto parallelismo. Il decode è memory-bound e ha bisogno di banda e di accessi alla memoria a bassa latenza. Se entrambe le fasi girano sullo stesso chip, una delle due è sempre penalizzata. Perché scendere a compromessi quando ci si può specializzare?
Al GTC 2026 Jensen Huang ha annunciato che NVIDIA si sta muovendo verso l'inferenza disaggregata. SambaNova e Intel hanno annunciato un'architettura simile: le GPU gestiscono il prefill (la costruzione della KV cache), le RDU il decode (la generazione veloce dei token) e le CPU Xeon l'orchestrazione e l'esecuzione degli strumenti.
Per i workload agentici questo conta ancora di più. Quando un agente affronta un compito complesso, può iterare decine di volte: ragiona, chiama strumenti, verifica i risultati e ricomincia. Ogni iterazione passa per la fase di decode, e la latenza si accumula da un'iterazione all'altra. Un decode 3x più veloce non rende solo più rapide le singole risposte, ma permette più passaggi di ragionamento nello stesso tempo a disposizione.
Non è teoria: i guadagni di efficienza sono troppo grandi per essere ignorati. È probabile che nei prossimi anni l'inferenza disaggregata diventi lo standard per i deployment ad alte prestazioni.
In sintesi
Sui modelli grandi l'inferenza su GPU va a sbattere contro un muro, perché il decode è memory-bound, non compute-bound. Il chip resta fermo in attesa dei dati. L'architettura dataflow risolve il problema con la spatial execution, una memoria a livelli, lo scheduling statico e pipeline continue. Il risultato è un'inferenza 3-10x più veloce sui workload memory-bound.
Il collo di bottiglia del decode non sparirà. Anzi, peggiora man mano che i modelli crescono e i workload agentici richiedono più token per task. Il settore risponde con hardware specializzato e architetture disaggregate. Infercom usa SambaNova perché oggi offre la migliore combinazione di velocità, efficienza e supporto ai modelli grandi per il deployment nell'UE. Ci adatteremo man mano che il panorama hardware evolve.
Non devi crederci sulla parola. Su benchmark.infercom.ai puoi provare i tuoi prompt sulla nostra infrastruttura. Artificial Analysis pubblica benchmark indipendenti su molti provider. Testa con le tue lunghezze tipiche di input e output, e testa nelle ore di punta. I vantaggi dell'architettura si vedono nei numeri.
Fai le tue misure: è l'unico modo per saperlo.
Approfondimenti
Risorse tecniche di SambaNova:
- Inference Speed or Throughput? With RDUs, You Don't Have to Choose
- The Decode Era of AI: Why Dataflow Matters More Than Ever
- Solving the Decode Bottleneck: Why Agentic Inference Needs Hybrid Hardware
Analisi indipendenti:
Risorse di Infercom: