Insights
Technische Deep Dives, Branchenanalysen und Perspektiven zur KI-Inferenz vom Infercom-Team.
Determinismus ist das falsche Ziel: ein Praxisleitfaden für konsistente LLM-Ergebnisse
Open-Weight-KI-Modelle: Warum sie ein strategischer Vorteil sind
713 Tokens pro Sekunde: Die Architektur hinter Ultraspeed
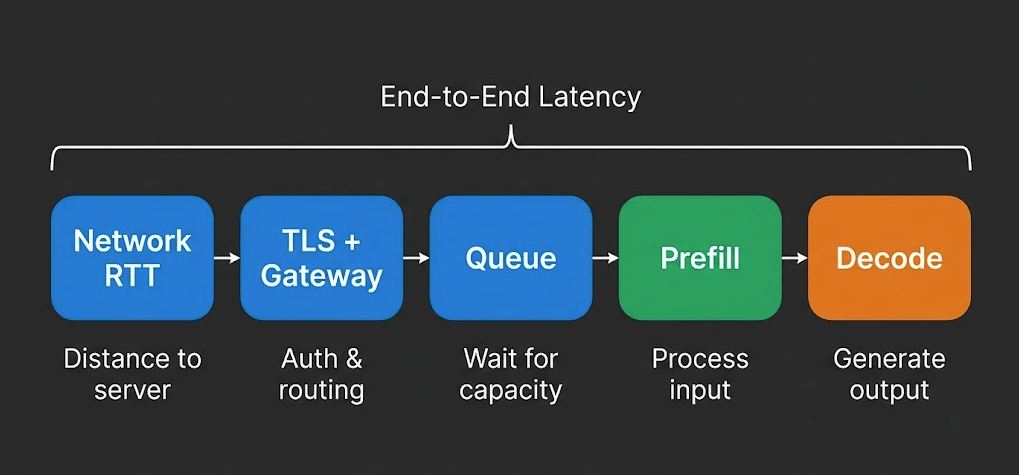
LLM Inference-Geschwindigkeit erklärt: TTFT, Durchsatz und was wirklich zählt
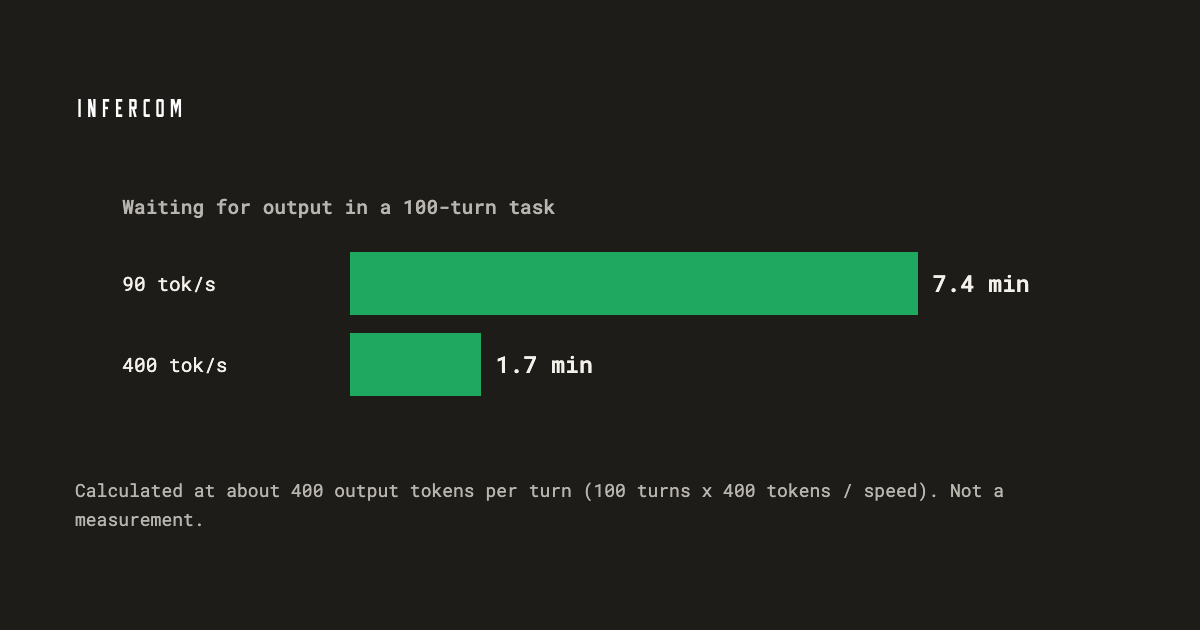
Inference-Geschwindigkeit beim Agentic Coding: Warum Token-Durchsatz wichtig ist
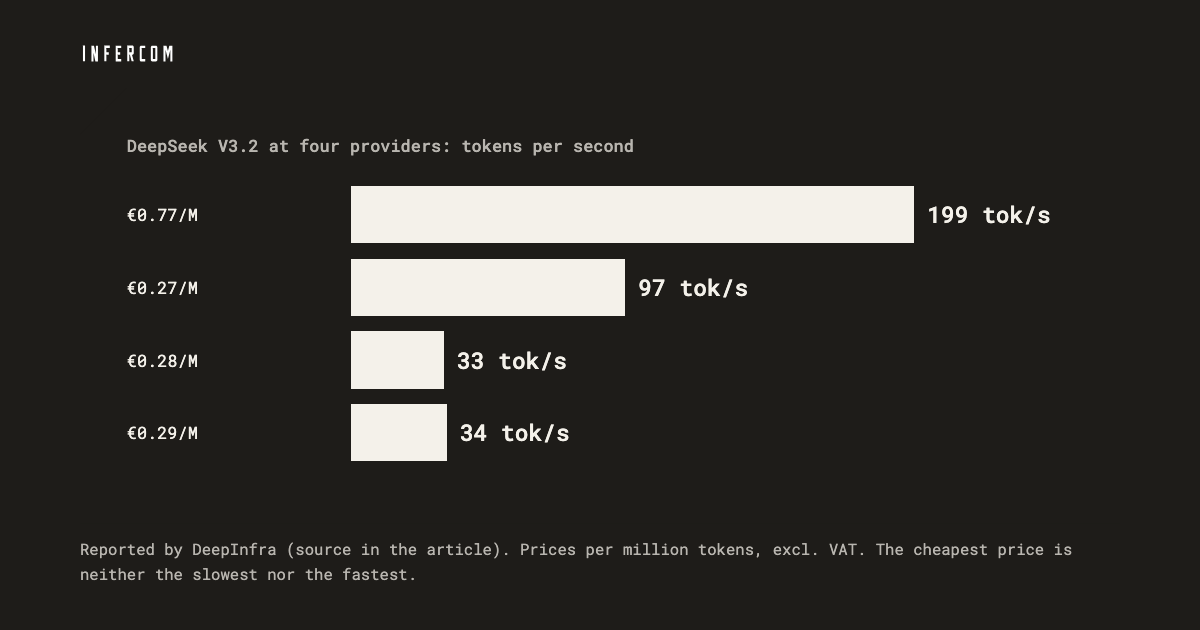
Was 'Preis pro Token' Ihnen nicht verrät