Technologie
Chips, entwickelt für schnelle KI-Inferenz
Wir betreiben offene Modelle auf Hardware, die wir für die jeweilige Aufgabe auswählen. Für schnelle Inferenz ist das heute der SN40L von SambaNova: Diese Chips lassen das Modell durch den Chip fließen, statt Daten ständig zwischen Chip und Speicher hin- und herzuschieben. So kommen Antworten früher an.
Ausgabe-Durchsatz, p50, 10K Input / 1K Output, einzelner Request. Zuletzt gemessen: Juli 2026.
Inferenz ist ein Speicherproblem, kein Rechenproblem
Ein Sprachmodell schreibt seine Antwort Token für Token. Für jedes Token holt eine GPU die Gewichte des Modells aus dem Speicher, rechnet und schreibt das Ergebnis zurück. Der Weg zum Speicher dauert viel länger als die Rechnung selbst, deshalb wartet die GPU in dieser Phase, dem Decode, die meiste Zeit. Anbieter überdecken das Warten, indem sie viele Nutzer zu einem Batch bündeln: Das System erzeugt insgesamt mehr Token, aber jede einzelne Antwort kommt langsamer an.
Dataflow: keine Umwege über den Speicher
Der Chip von SambaNova, die RDU (Reconfigurable Dataflow Unit), verteilt die Rechenschritte einer ganzen Modellschicht über den Chip und lässt die Daten hindurchfließen. Die Gewichte kommen aus dem Hochbandbreitenspeicher (HBM) im selben Gehäuse. Alles, was dazwischen berechnet wird, bleibt auf dem Chip, statt nach jedem Schritt in den Speicher zurückzugehen. So nutzt der Chip fast 85% seiner Speicherbandbreite für die Gewichte (SambaNova, Paper zum SN40L).
Jeder Chip kann den Speicher aller 16 Chips eines Racks ansprechen. Deshalb bedient ein einziges Rack Modelle mit mehreren hundert Milliarden Parametern.
Der Zielkonflikt
Ein Chip bearbeitet jeweils einen kleinen Batch von Requests. Dadurch bleibt jede Antwort schnell. Bei Massenaufträgen, auf deren Ergebnis niemand wartet, zählt dagegen der maximale Durchsatz im Batch mehr als die Geschwindigkeit pro Request.
Was sich in der Praxis ändert
Entwickler
Schnelle Token für jeden einzelnen Request, nicht nur in der Summe: 713 tok/s mit gpt-oss-120b und 428 tok/s mit MiniMax M2.7, gemessen auf unserer API. Ein Agent schafft in derselben Zeit mehr Schritte.
Plattform-Teams
Große Modelle auf einem einzigen Rack. Mehrere Modelle bleiben gleichzeitig im Speicher und wechseln in Millisekunden, sodass ein dediziertes Rack Ihre feinabgestimmten Checkpoints nebeneinander betreiben kann. Lange Kontexte: 192K Token bei MiniMax M2.7, 128K bei gpt-oss-120b und Gemma 4. Bei MiniMax M2.7 kommt wiederholter Kontext aus einem Prompt-Cache im Speicher der Chips und wird nie auf einen Datenträger geschrieben.
Geschäftsführung und Nachhaltigkeit
Weniger Datenbewegung macht den Chip schnell, und sie spart auch Energie: Ein Request, der früher fertig ist, braucht für kürzere Zeit Strom, und ein großes Modell passt auf weniger Chips. SambaNova gibt eine bis zu 5x höhere Energieeffizienz als bei einer GPU an (2,5x bis 5,6x gegenüber einer NVIDIA H200 mit Llama 70B, je nach Batchgröße, 2025). Ein Rack braucht im typischen Betrieb rund 10 kW und ist luftgekühlt. Damit passt es in die Rechenzentren, die es heute gibt.
Wie wir entscheiden, was darunter läuft
Wir sind ein Inferenz-Anbieter, kein Chiphersteller. Jede Hardware prüfen wir anhand von fünf Fragen, in dieser Reihenfolge:
- 01
Passt sie in die Rechenzentren, die es in Europa gibt?
Strom und Kühlung stehen an erster Stelle. Luftgekühlte Racks passen überall hin, Kapazität für Flüssigkühlung ist knapp.
- 02
Gibt es einen vollständigen Software-Stack?
Ein Chip ist noch kein Dienst. Wir brauchen Compiler, Runtime und Serving-Schicht, die daraus eine API machen.
- 03
Wie schnell ist sie mit den Modellen, die unsere Kunden nutzen?
Große, aktuelle offene Modelle, von uns selbst gemessen.
- 04
Was kostet sie insgesamt?
Hardware, Strom und Betrieb pro Million Token.
- 05
Wo läuft sie, und wer betreibt sie?
Auf Hardware, die uns gehört, in der EU.
Für schnelle Inferenz beantwortet der SN40L von SambaNova diese Fragen heute am besten, und jedes Modell, das wir in München anbieten, läuft darauf. Was auch immer darunter läuft: Sie nutzen dieselbe API.
Technische Daten des SN40L
Chip: SambaNova SN40L RDU
- Fertigung
- TSMC 5nm
- Gehäuse
- Zwei Dies in einem Gehäuse (CoWoS)
- Recheneinheiten
- 1040 (PCUs)
- Spitzenleistung (BF16)
- 638 TFLOPS
- Speicher pro Chip
- 520 MB SRAM, 64 GB HBM, bis zu 1,5 TB DDR
Rack: SambaRack SN40L-16
- Chips
- 16 RDUs
- Spitzenleistung (BF16)
- 10.2 PFLOPS
- Speicher
- 8 GB SRAM, 1 TB HBM, 12 TB DDR
- Leistung
- 7 bis 14,5 kW bei Inferenz, typisch 10 kW
- Kühlung
- Luft
- Maße (H x B x T)
- 1994 x 610 x 1270 mm
- Gewicht
- 485 kg
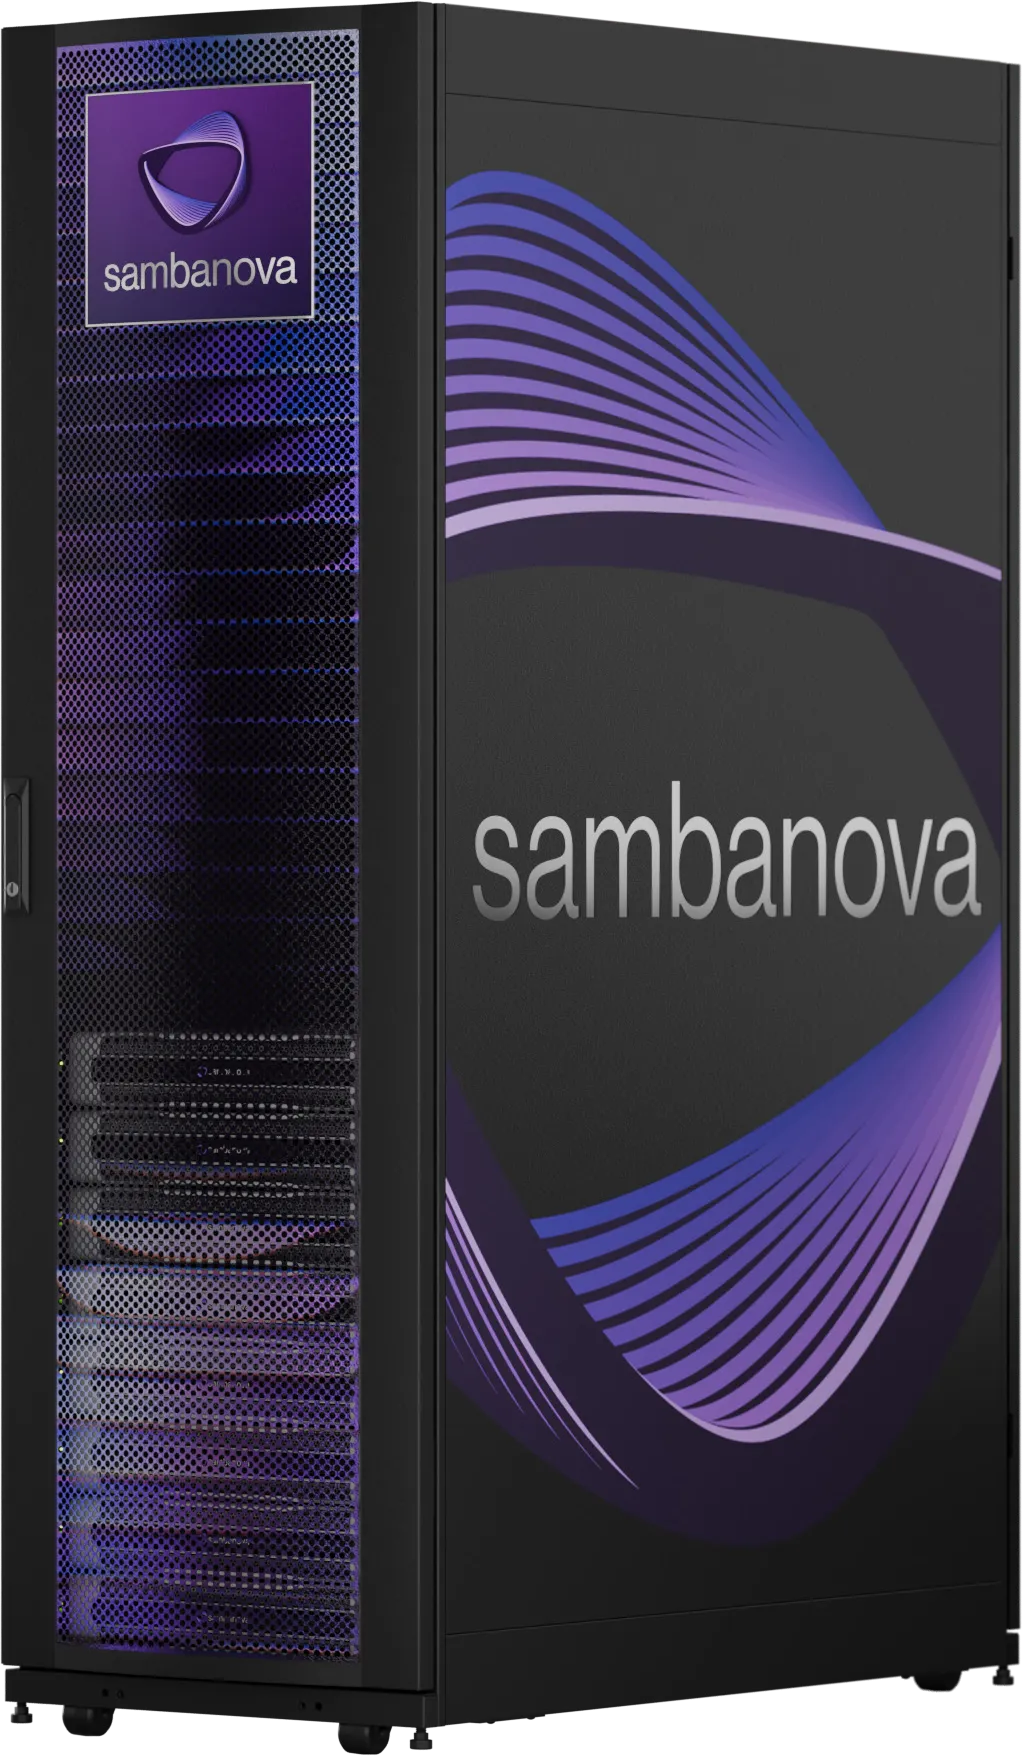
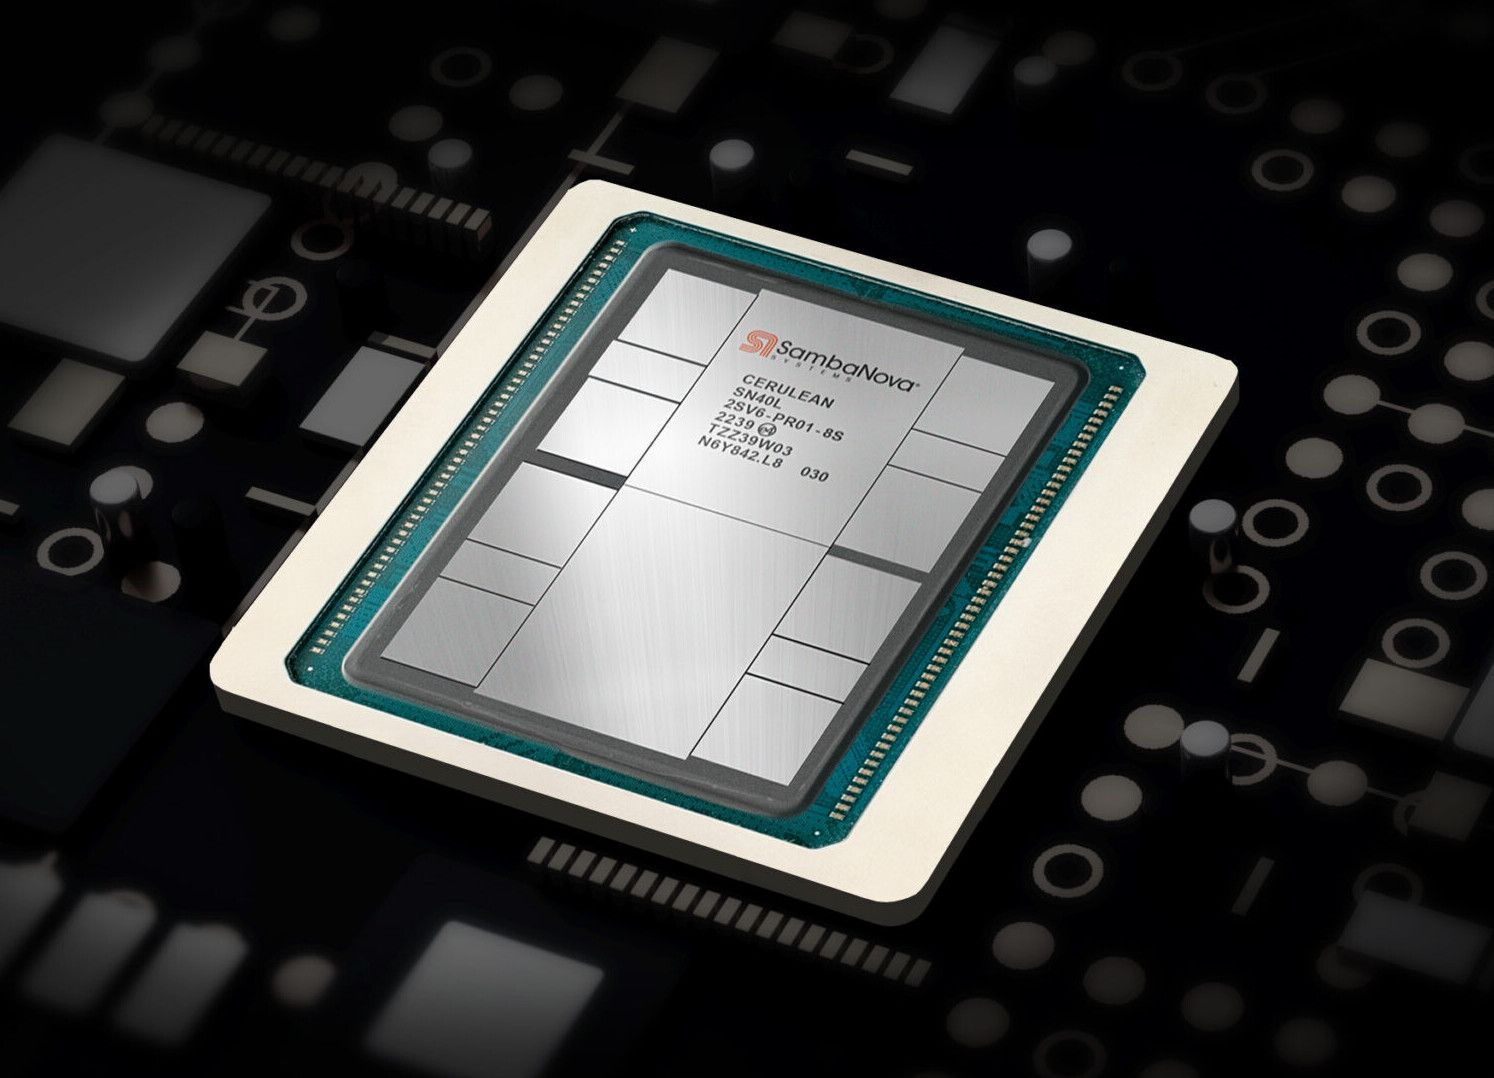
Unsere Installation: 8 Racks mit 128 RDUs bei Equinix München 4.
In München, auf eigener Hardware
- Equinix München 4, Deutschland. Die Racks gehören Infercom.
- Das Rechenzentrum bezieht zu 100% Strom aus erneuerbaren Quellen, über Herkunftsnachweise.
- Es kühlt mit Trockenkühlern und freier Kühlung. Die Chips brauchen kein Wasser zur Kühlung.
- Das Rechenzentrum ist nach ISO 27001, ISO 14001 und ISO 50001 zertifiziert.
Die Software von SambaNova betreibt die Modelle, und SambaNova unterstützt Teile des Betriebs. Was das für Ihre Daten bedeutet
Fragen
Was ist eine Reconfigurable Dataflow Unit (RDU)?
Der KI-Chip von SambaNova. Statt ein Modell Schritt für Schritt auszuführen und zwischendurch in den Speicher zurückzugehen, verteilt er die Rechenschritte des Modells über den Chip und lässt die Daten hindurchfließen. Infercom betreibt die Generation SN40L.
Warum ist Dataflow bei der Inferenz schneller als eine GPU?
Während sie eine Antwort schreibt, führt eine GPU eine Modellschicht in vielen einzelnen Schritten aus und schreibt die Ergebnisse dazwischen in den Speicher zurück. Ein Dataflow-Chip führt die ganze Schicht in einem Schritt aus und behält diese Ergebnisse auf dem Chip. So nutzt er seine Speicherbandbreite für die Gewichte und antwortet früher.
Welche Hardware betreibt Infercom?
Systeme vom Typ SambaRack SN40L-16 mit SN40L-Chips von SambaNova: 8 Racks mit 128 Chips bei Equinix München 4. Wir haben sie für schnelle Inferenz ausgewählt.
Betreiben Sie den SN50 von SambaNova?
Nein, in unseren Racks arbeitet der SN40L, und alle Angaben auf dieser Seite beziehen sich auf den SN40L.
Wie viel Strom braucht ein Rack, und braucht es Flüssigkühlung?
Im typischen Betrieb rund 10 kW (7 bis 14,5 kW bei Inferenz). Flüssigkühlung braucht es nicht: Das Rack ist luftgekühlt und passt in Rechenzentren, die für normale Server gebaut sind.
Kann ein Rack mehrere Modelle betreiben?
Ja: Mehrere Modelle bleiben gleichzeitig im Speicher, und das Rack wechselt in Millisekunden zwischen ihnen. Auf einem dedizierten Rack können Sie so Ihre eigenen feinabgestimmten Checkpoints nebeneinander betreiben.
Weiterlesen
- Architektur-Paper zum SN40L Der Chip, seine drei Speicherebenen und der Modellwechsel, beschrieben von den Ingenieuren von SambaNova (arXiv, englisch).
- Datenblatt SambaRack SN40L-16 Technische Daten des Racks: Chips, Speicher, Leistung und Maße (SambaNova, englisch).
- Intelligence per Watt Unabhängige Studie zur Energieeffizienz von KI-Beschleunigern, darunter der SN40L (Stanford, arXiv, englisch).
- Intelligence per Joule SambaNova über Energieeffizienz als Maßstab für KI-Infrastruktur (englisch).
- 713 Tokens pro Sekunde: Die Architektur hinter Ultraspeed Unser Deep Dive zu Dataflow und Decode, mit den Messungen vom Mai 2026.
- Glossar RDU, Dataflow-Architektur, Prefill und Decode, Token pro Sekunde.