EU-souveräne KI-Inferenz
Ihre KI, in Europa. Schneller, als Sie es gewohnt sind.
Schnelle KI-Inferenz, über die Sie die Kontrolle behalten: Open-Weight-Modelle auf Hardware, die für KI entwickelt ist und die wir in München besitzen und betreiben. Eine OpenAI-kompatible API, vom ersten API-Key bis zu Ihren eigenen Racks.
Agenten, die Sie nicht warten lassen.
Antworten, bevor die Pause unangenehm wird.
Ihr Termin ist auf Dienstag, 10:30 Uhr verschoben. Kann ich sonst noch etwas für Sie tun?
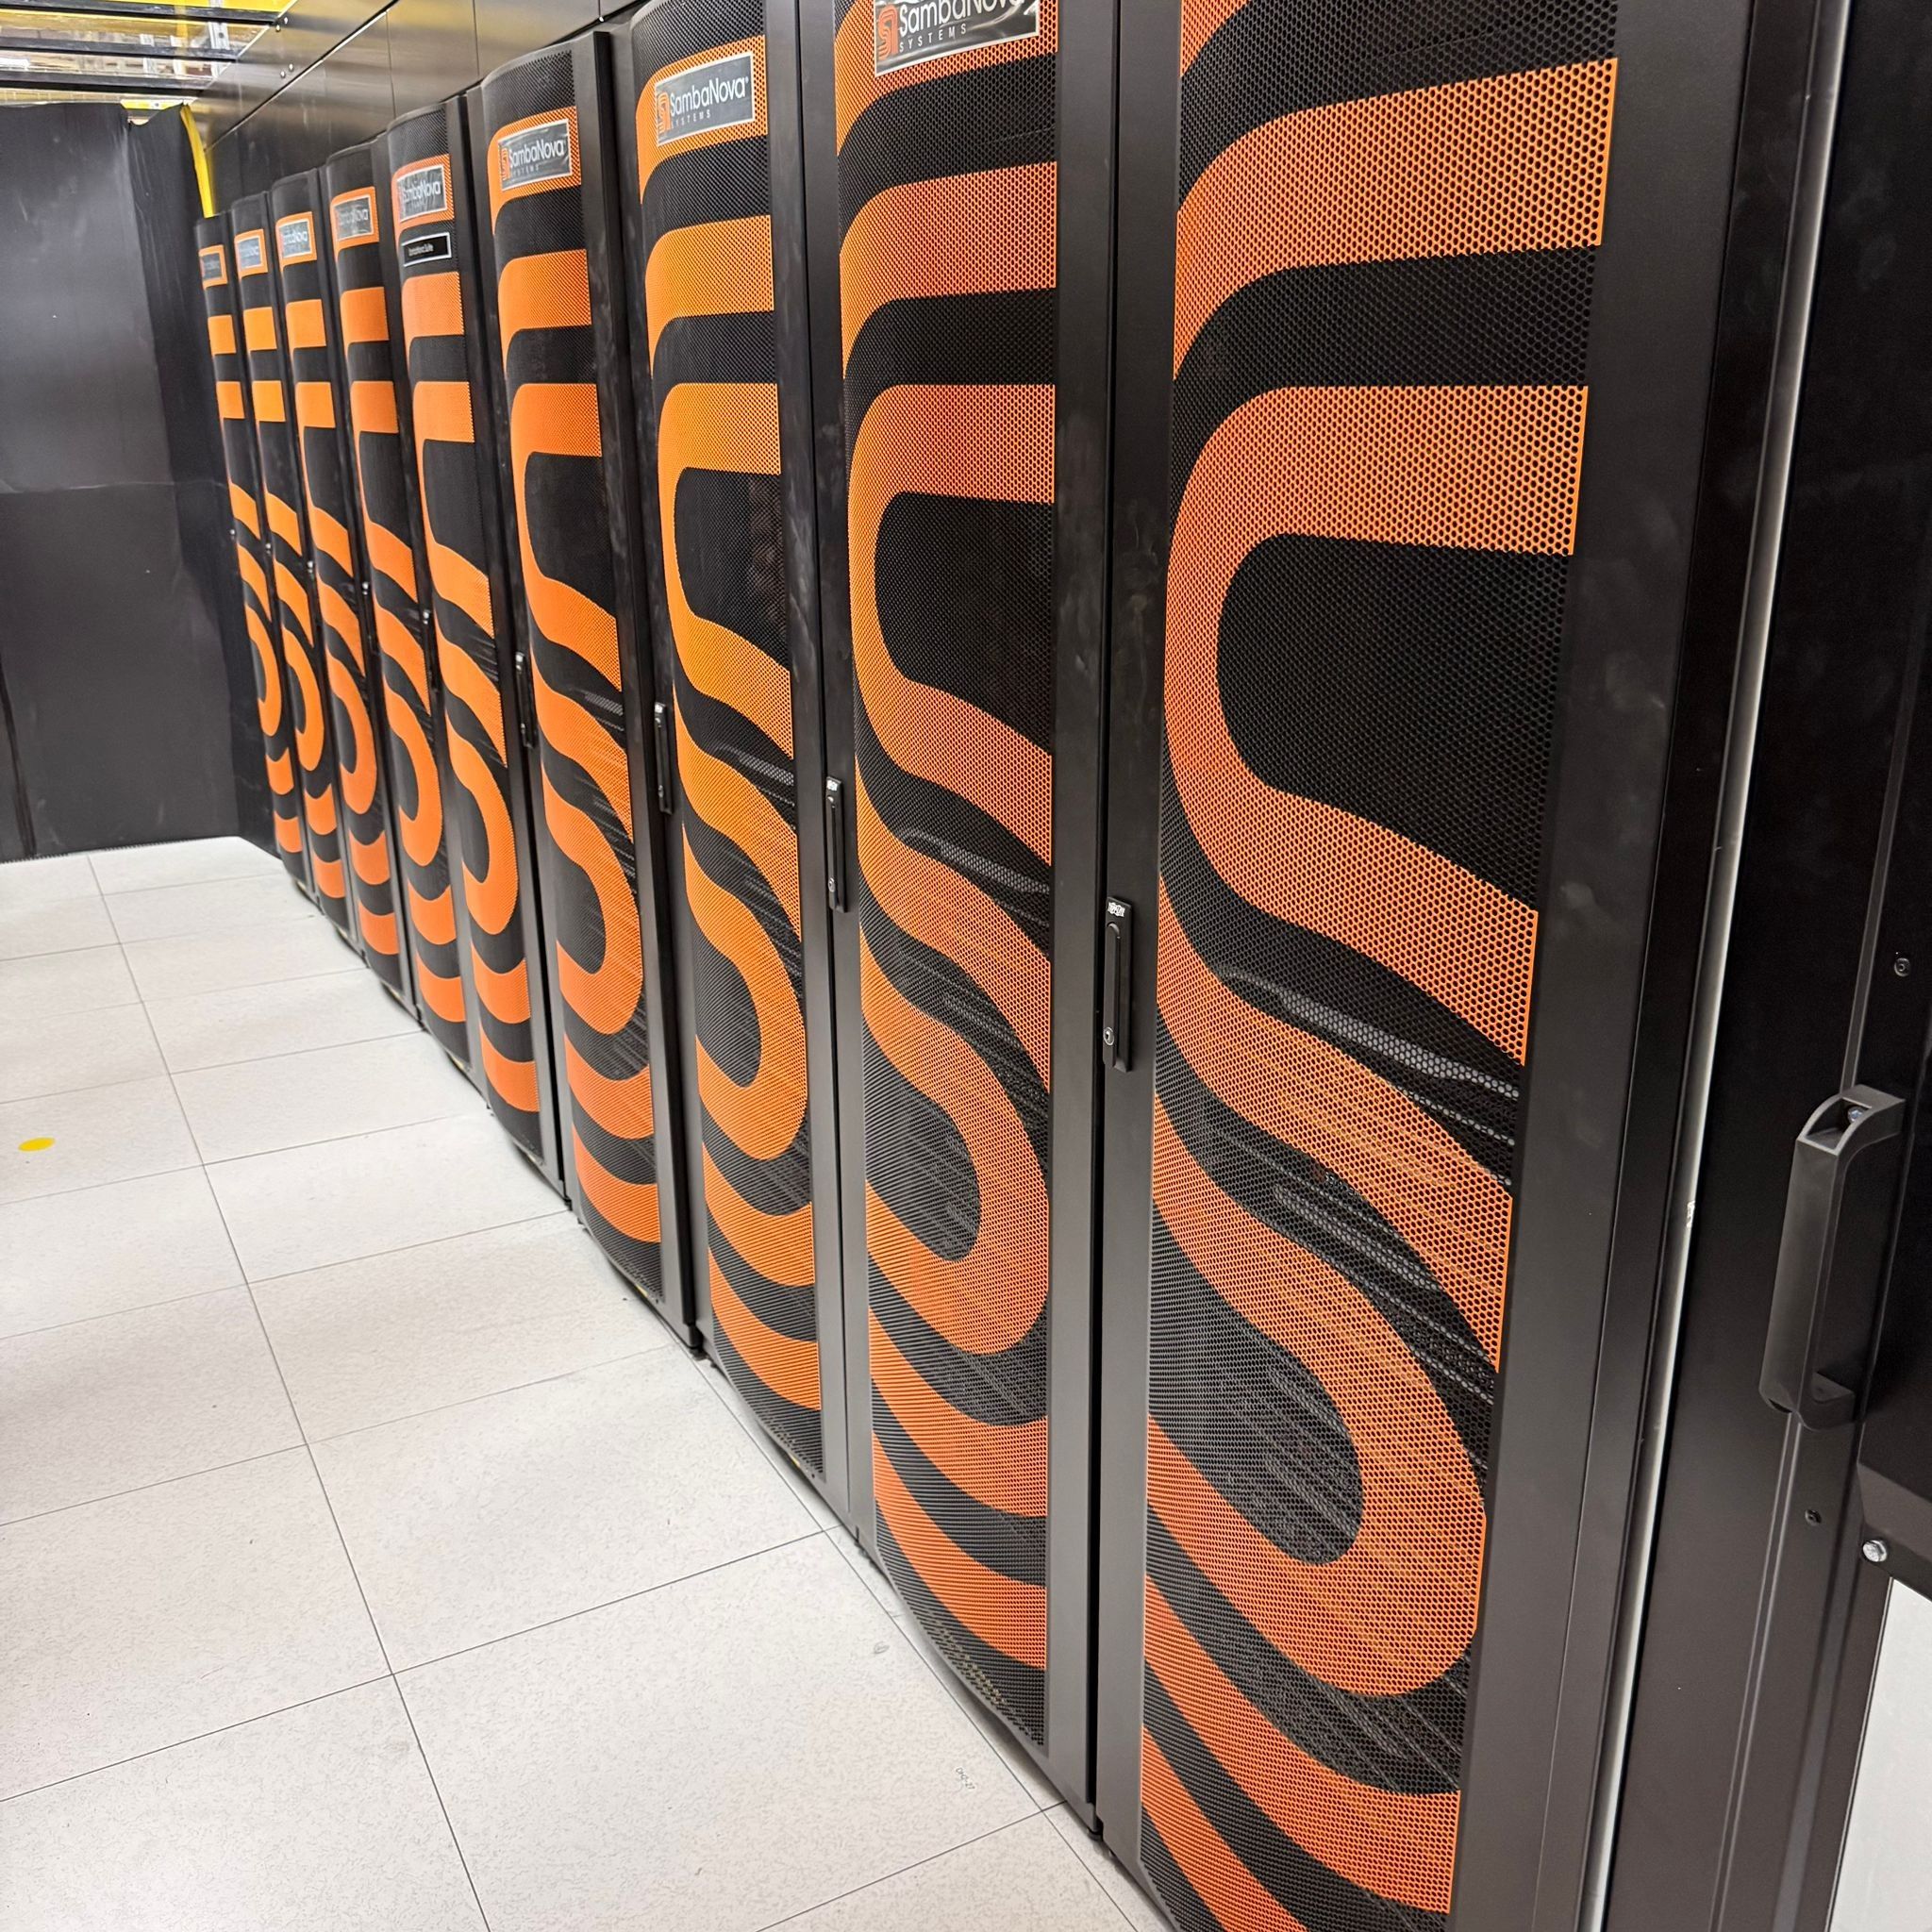
Ihre Daten bleiben in Europa.
- EU-souveräne Modelle
- Zero Data Retention Policy
- Nach ISO 27001 zertifiziert
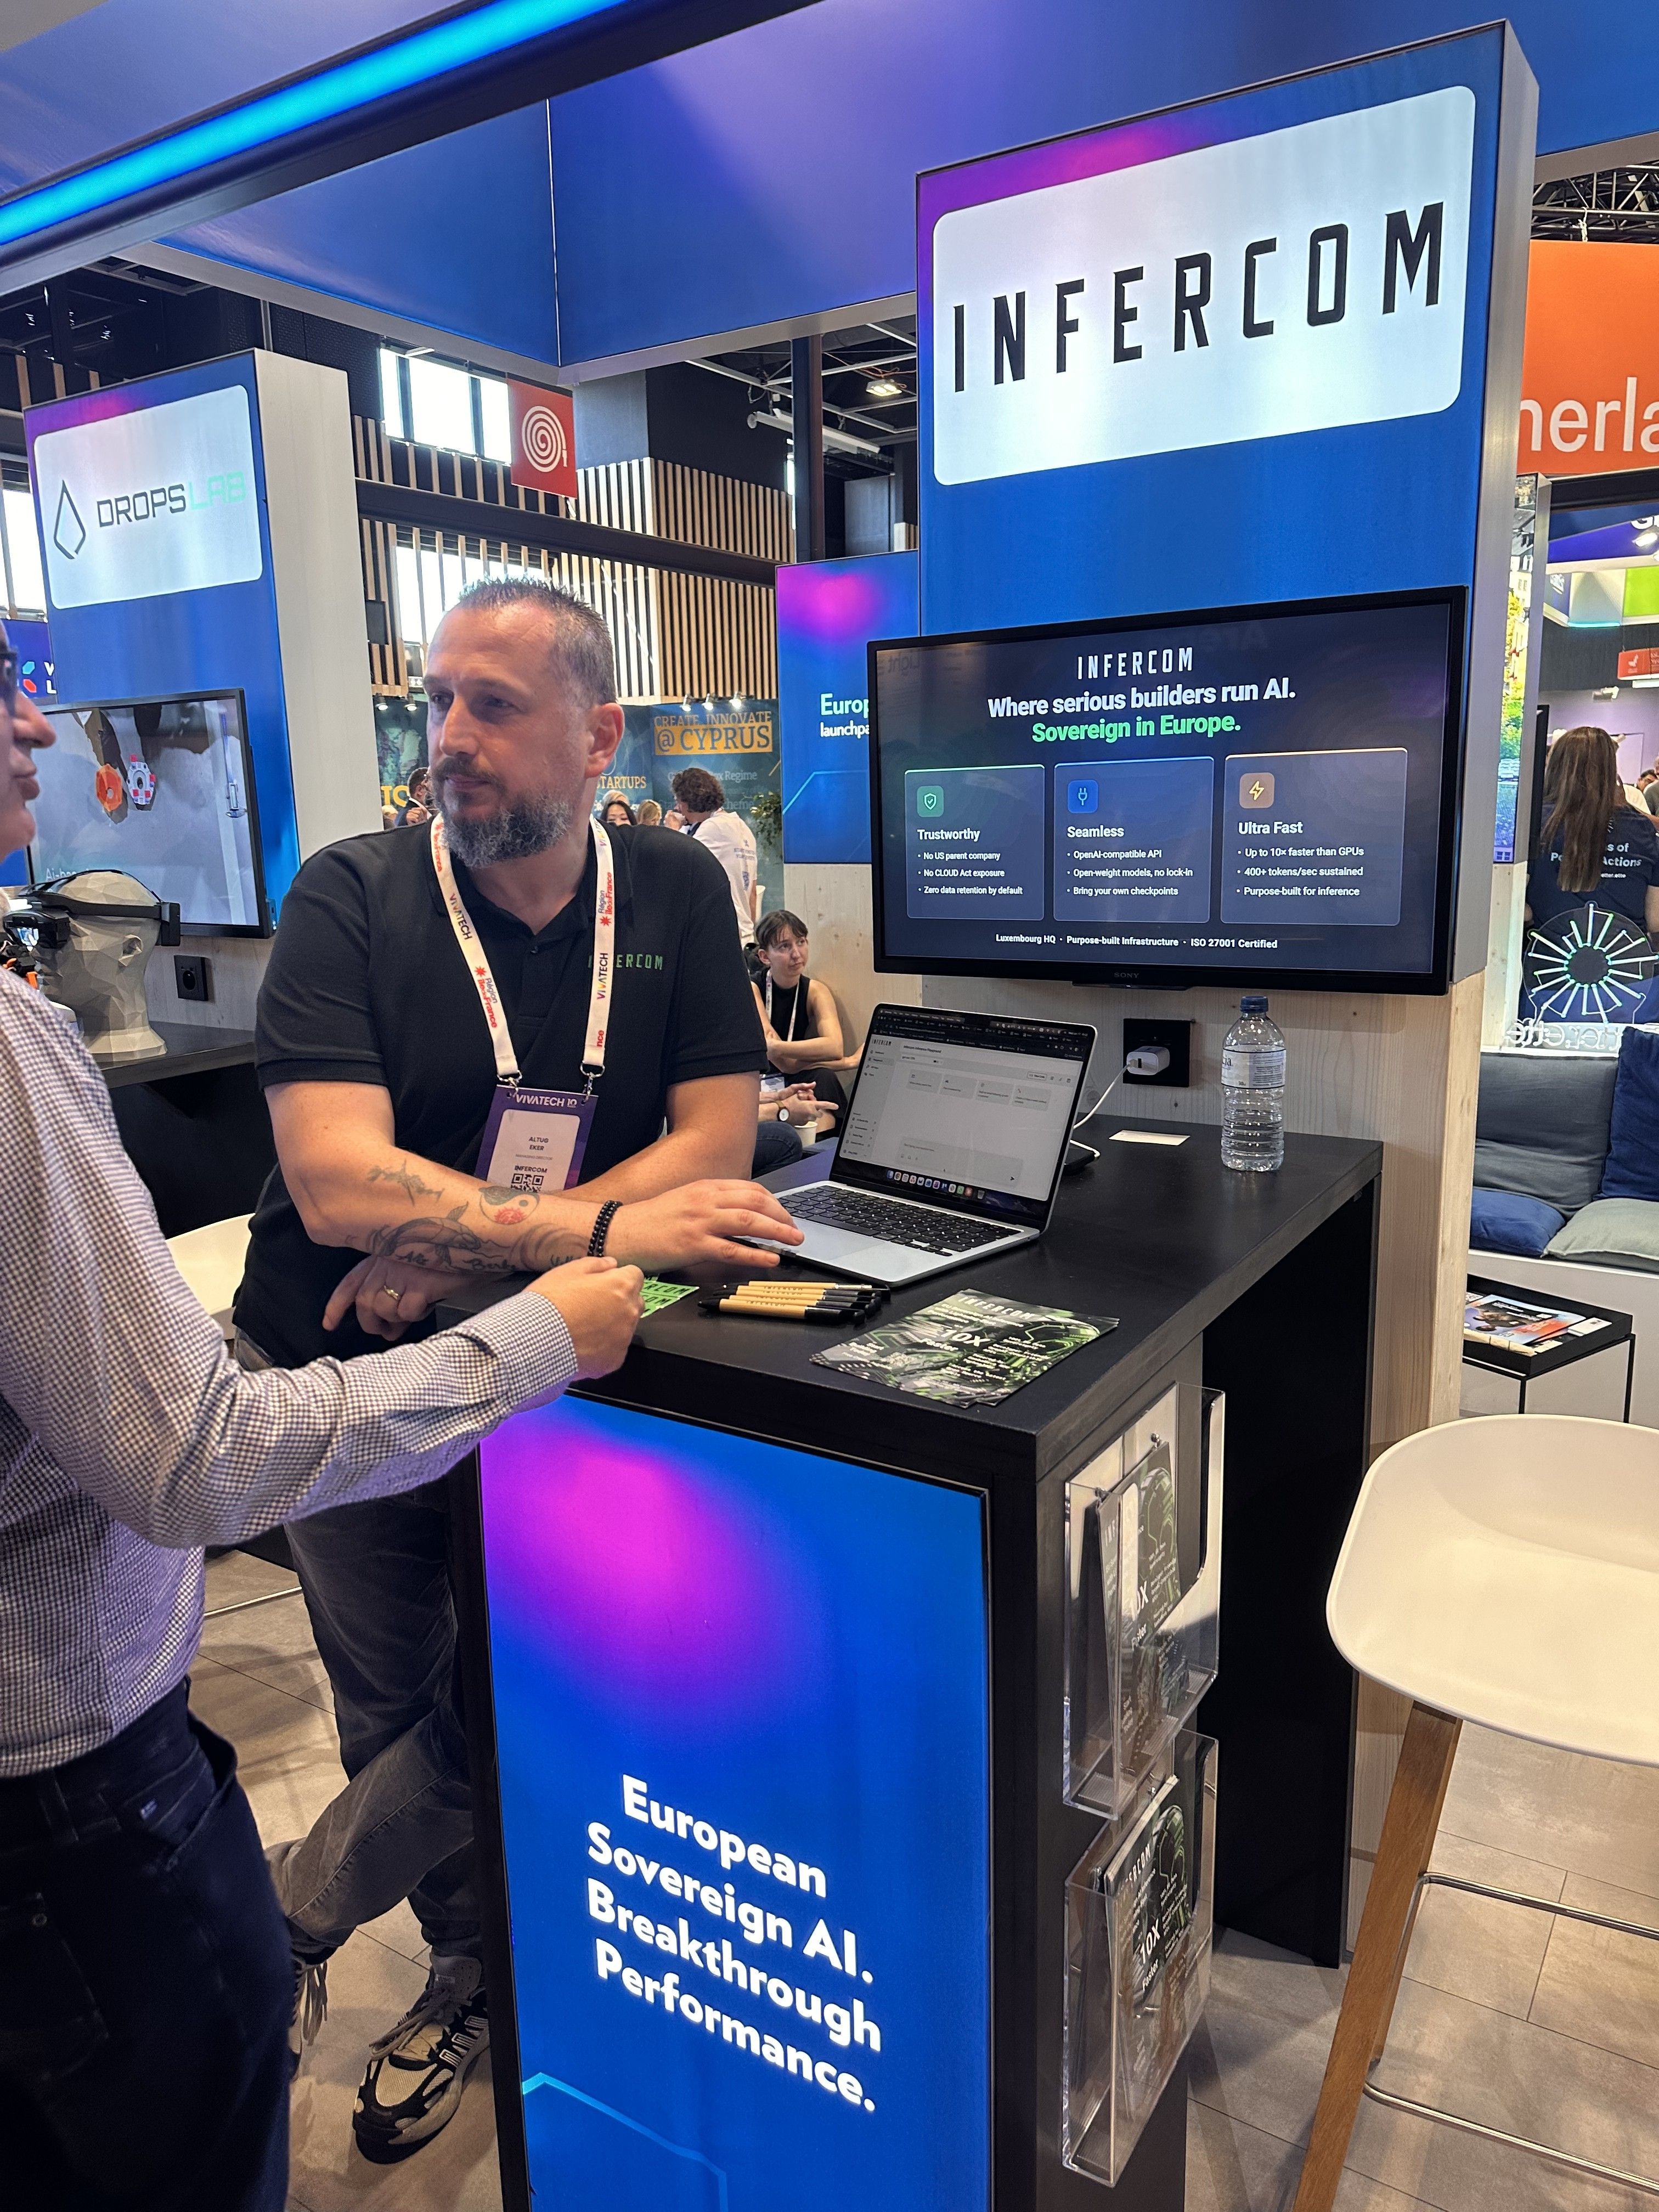
Menschen, die Sie erreichen.
- Luxemburger Unternehmen, keine US-Muttergesellschaft
- Ein Team, mit dem Sie direkt sprechen
- Vom ersten Key bis zu Ihren eigenen Racks
Ausgabe-Durchsatz, p50, 10K Input / 1K Output, einzelner Request. Zuletzt gemessen: Juli 2026.
Warum es wichtig ist
Woran KI-Produkte scheitern
Jemand anderes entscheidet
Ihre Daten, Ihre Modelle und Ihr Service hängen von einem Anbieter ab. Wenn sich dessen Rechtslage, Eigentümer oder Modellkatalog ändert, ändert sich Ihr Produkt mit.
Langsame Antworten
Voice-Agenten stocken, Coding-Agenten hängen, Nutzer springen ab. Bei vielen Produkten ist Geschwindigkeit kein Detail. Sie ist das Produkt.
Was wir tun
Open-Weight-Modelle auf unserer eigenen Hardware
Wir betreiben Open-Weight-Modelle auf Hardware, die wir selbst gekauft haben und selbst betreiben, in einem Rechenzentrum in München. Nur Inferenz: Wir trainieren keine Modelle, und Prompts und Ausgaben werden nie auf eine Festplatte geschrieben.
- Luxemburger Unternehmen, kontrolliert in Europa, keine US-Muttergesellschaft
- EU-souveräne Modelle, verarbeitet in München
- Jede Abhängigkeit benannt, auch das, was noch nicht europäisch ist
Warum es schnell ist
Für Inferenz entwickelt, nicht umfunktioniert
Chips, entwickelt für KI, halten die Arbeitsdaten des Modells direkt bei der Rechenlogik. Die Daten wandern nicht ständig hin und her wie auf GPUs. Das Ergebnis ist bis zu 10x schnellere Inferenz als bei GPU-basierten Alternativen, gemessen auf unserer Produktions-API, mit veröffentlichter Methode.
Modelle
Modelle, die in München laufen
Aktuelle Open-Weight-Modelle, betrieben in der Genauigkeit, in der ihre Herausgeber sie veröffentlicht haben.
Ausprobieren
Wechseln mit einer Zeile
Richten Sie Ihr OpenAI-SDK auf unseren Endpoint und wählen Sie ein Modell. Sonst ändert sich nichts in Ihrem Code.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.infercom.ai/v1",  # the one line that changes
    api_key="your-api-key",
)

response = client.chat.completions.create(
    model="MiniMax-M2.7",
    messages=[{"role": "user", "content": "Hello from Munich"}],
)
Wachsen ohne Wechsel
Dieselbe API, vom ersten Key bis zu Ihren eigenen Racks
Es ändern sich nur das Betriebsmodell und der Standort. Ihr Code und die Performance bleiben gleich.
Wer darauf baut
Europäische Router, Plattformen und Lösungen laufen auf Infercom





That device is limited and we need infrastructure, and private infrastructure. That's why we are working with Infercom, to actually run bigger models with lower latency.
 Levent AkyilCEO & CTO, co-mind.ai
Wer wir sind
Wir kümmern uns um die Infrastruktur, damit Sie sich auf Ihr Produkt konzentrieren können
Wir wählen und gestalten die Infrastruktur, die zu jeder Aufgabe passt, und betreiben sie für Sie. Heute sind das die Chips von SambaNova, entwickelt für schnelle Inferenz. Ein kleines europäisches Team, das Sie direkt erreichen, mit einer Roadmap, die Sie mitgestalten können.