Der Begriff wird ständig mit "Open Source" gleichgesetzt, und der Unterschied ist vielen nicht klar. Deshalb klären wir ihn zuerst. Danach zeigen wir, warum Open-Weight-Modelle auf souveräner Infrastruktur europäischen Unternehmen Vorteile bieten, die proprietäre APIs strukturell nicht bieten können.
Zuerst die Unterscheidung: Open Weight ≠ Open Source
Die beiden Begriffe klingen austauschbar, sind es aber nicht.
Ein Open-Weight-Modell stellt Ihnen die trainierten Parameter zur Verfügung, also die Milliarden von Zahlen, in denen das Wissen des Modells steckt. Sie können sie herunterladen, ausführen und (je nach Lizenz) per Fine-Tuning anpassen.
Ein Open-Source-Modell liefert all das und zusätzlich den Bauplan: den Trainingscode, die Trainingsdaten und alles, was nötig ist, um das Modell von Grund auf neu zu bauen.
Seit die Open Source Initiative, die die Liste der anerkannten Open-Source-Softwarelizenzen pflegt, im Oktober 2024 ihre Open Source AI Definition veröffentlicht hat, zieht die Branche eine klare Grenze zwischen beiden. In der Praxis gilt: Fast jedes Modell, das heute als "Open Source" vermarktet wird, darunter DeepSeek, Qwen und Gemma, ist nur Open Weight.
| Aspekt | Echtes Open Source | Open Weight | Proprietär (GPT, Claude) |
|---|---|---|---|
| Modellgewichte | ✓ | ✓ | ✗ |
| Trainingscode | ✓ | ✗ | ✗ |
| Trainingsdaten | ✓ | ✗ | ✗ |
| Betrieb auf Infrastruktur Ihrer Wahl | ✓ | ✓ | ✗ |
| Recht auf Änderung / Fine-Tuning | Vollständig | Je nach Lizenz | Keine |
Für Ihr Unternehmen zählt vor allem die vierte Zeile: Open-Weight-Modelle laufen auf der Infrastruktur, die Sie wählen. Aus dieser einen Eigenschaft ergeben sich die strategischen Vorteile.
Aber taugen Open-Weight-Modelle überhaupt etwas?
Das ist meist die erste Frage, und sie ist berechtigt. Die Kontrolle über den Datenpfad und die Freiheit von Lock-in nützen wenig, wenn das Modell darunter der Aufgabe nicht gewachsen ist. Vor einigen Jahren lautete die ehrliche Antwort noch: "nah dran, aber klar einen Schritt zurück". Das stimmt heute nicht mehr.
Der Abstand zwischen den besten Open-Weight-Modellen und den besten geschlossenen, proprietären Modellen ist stark geschrumpft. 2024 betrug er bei gängigen Benchmarks oft 30 Punkte oder mehr. 2026 liegt er bei den meisten Alltagsaufgaben im niedrigen einstelligen Bereich. Laut einer Studie von MIT Sloan und Georgia Tech aus dem Jahr 2026 erreichen offene Modelle zum Start rund 90% der Leistung geschlossener Modelle und schließen die restliche Lücke oft innerhalb von Monaten, bei einem Bruchteil der Kosten. Der unabhängige Tracker Epoch AI misst den Rückstand in Monaten, nicht in Generationen, und stellt fest, dass er nicht wächst.
Bei dem, was die meisten Unternehmen tatsächlich bauen, also Zusammenfassungen, Datenextraktion, Kundensupport, Content-Erstellung und vor allem Coding, ist der Unterschied zwischen einem offenen und einem geschlossenen Spitzenmodell in der Praxis oft nicht zu erkennen. Beim Coding haben Open Weights am deutlichsten aufgeholt: MiniMax und DeepSeek liegen bei realen Softwareaufgaben inzwischen nah an der Spitze, weshalb sie für Agentic Coding beliebt geworden sind.
Wo zeigt sich die Lücke noch? Beim anspruchsvollsten Reasoning an der Spitze der Forschung, bei komplexen mehrstufigen agentischen Workflows und beim breitesten Allgemeinwissen haben die führenden geschlossenen Modelle weiterhin einen Vorsprung. Das wollen wir nicht beschönigen: Wenn Ihr Anwendungsfall dort liegt, testen Sie sorgfältig. Für die große Mehrheit der Produktions-Workloads sind Open-Weight-Modelle aber kein Kompromiss, den Sie der Souveränität zuliebe in Kauf nehmen. Sie sind gut, und das können Sie selbst prüfen: Artificial Analysis veröffentlicht unabhängige, laufend aktualisierte Rankings. Das verlässlichste Signal ist aber ein Test des infrage kommenden Modells mit Ihrem eigenen Workload.
Warum das für Ihr Unternehmen zählt
Kein Vendor Lock-in
Bei einem proprietären Modell bekommen Sie die Gewichte nie. Der Eigentümer behält deshalb die Kontrolle, egal wo das Modell physisch läuft. Es kann über seine eigene API laufen oder über einen lizenzierten Cloud-Partner, die Bedingungen legt aber weiterhin der Eigentümer fest: Preise, Kapazitätsgrenzen, Nutzungsrichtlinien und den Zeitplan für Abkündigungen. Ein Cloud-Partner ändert, wer die Rechenleistung stellt, nicht, wer das Modell kontrolliert. Wird eine Version abgekündigt oder ändern sich die Limits, müssen Sie sich anpassen, und zwar nach seinem Zeitplan, nicht nach Ihrem.
Open-Weight-Modelle lösen diese Abhängigkeit auf:
- Sie können den Anbieter wechseln und das Modell behalten. Erhöht ein Anbieter die Preise oder wird sein Service schlechter, ziehen Sie mit demselben Modell woanders hin.
- Sie können das Modell wechseln, ohne Ihre Architektur umzubauen. Übertrifft das nächste Release von MiniMax Ihr aktuelles Modell, migrieren Sie über dieselbe OpenAI-kompatible API.
- Es gibt keine erzwungenen Abkündigungen. Ein Open-Weight-Modell, auf das Sie sich verlassen, verschwindet nicht, nur weil ein Anbieter es einstellen will.
Das erklärt auch das Ergebnis der AI-Pulse-Umfrage von KPMG aus Q2 2026: 95% der Organisationen haben inzwischen eine formale KI-Strategie, und der Trend zu Open-Weight-Modellen wird vor allem von Flexibilität und Kostenvermeidung getrieben. Es geht um die Möglichkeit, sich der Sogwirkung eines einzelnen Anbieters zu entziehen.
Ihre Daten bleiben außer Reichweite des Modellherstellers
Diesen Vorteil unterschätzen die meisten Käufer.
Bei einer proprietären API läuft jeder Prompt, den Sie senden, durch die Infrastruktur des Modellherstellers. Bei einem Open-Weight-Modell, das Infercom betreibt, sieht der Modellhersteller, ob Google, OpenAI oder MiniMax, Ihre Daten überhaupt nicht. Er hat die Gewichte veröffentlicht und betreibt nichts in Ihrem Datenpfad.
Ihre Daten gehen stattdessen an unsere Infrastruktur in der EU und unterliegen der EU-Jurisdiktion. Aus welchem Land das Modell stammt, spielt keine Rolle dafür, wo Ihre Daten liegen, weil der Modellhersteller nichts hostet.
Wer sitzt in Ihrem Datenpfad?
So unterscheidet sich ein gemietetes proprietäres Modell von Open Weights auf einer Infrastruktur, der Sie vertrauen.
Proprietäre API
Ihre App
Cloud des Modellherstellers
Sieht jeden Prompt, den Sie senden.
Ihre App
Ihre Daten laufen durch die Infrastruktur des Modellherstellers.
Open Weights auf Infercom
Modellhersteller
Veröffentlicht nur Gewichte
keine Verbindung
Ihre App
Infercom · EU-Infrastruktur
EU-Jurisdiktion
Ihre App
Der Modellhersteller ist nicht in Ihrem Datenpfad. Ihre Daten bleiben unter EU-Jurisdiktion.
Eine Kostenstruktur ohne die Marge des Modellherstellers
In den Preisen proprietärer APIs steckt die Marge des Modellherstellers: die Amortisation der Forschung und Entwicklung, sein Gewinn und die Kosten für seinen Wettbewerbsvorsprung. Open-Weight-Preise spiegeln die Rechenleistung für die Inferenz wider. Es gibt keine Lizenz pro Nutzer an das Labor und keinen API-Aufschlag obendrauf. Wenn bessere offene Modelle erscheinen, profitieren Sie sofort, ohne einen Enterprise-Vertrag neu verhandeln zu müssen.
Die Kosten sind für unsere Kunden meist nicht der erste Grund, sich für Open Weights zu entscheiden, denn Souveränität und Performance zählen mehr. Der strukturelle Unterschied ist aber real, und er wächst mit dem Volumen.
Sie können eigene fine-getunte Modelle betreiben
Mit Open Weights können Sie ein Modell per Fine-Tuning mit Ihren eigenen Daten anpassen, an Ihr Fachgebiet, Ihre Terminologie und Ihre Aufgaben. Unter permissiven Lizenzen gehört der entstandene Checkpoint Ihnen. Er ist mit Ihren Daten trainiert, die Gewichte bleiben vollständig privat, das ursprüngliche Labor erhält keine Umsatzbeteiligung, und eine Genehmigung brauchen Sie nicht.
Mit einer proprietären API ist das nicht möglich, denn dort ist das Modell eine Blackbox, die Sie mieten, aber nie besitzen. Und sobald Sie ein fine-getuntes Modell haben, brauchen Sie einen Ort, an dem es läuft. Unsere Angebote Dedicated und On-Premises hosten Ihre fine-getunten Checkpoints auf Infrastruktur in der EU. So läuft Ihr eigenes Modell, das auf Ihrem geistigen Eigentum aufbaut, mit derselben Souveränität und Kontrolle wie alles andere in Ihrem Stack. (Unsere geteilte API stellt die Basismodelle bereit, eigene Checkpoints laufen auf Dedicated oder On-Premises.)
Autor und Buch: Warum der Modellhersteller nicht an Ihre Daten kommt
Warum der Modellhersteller Ihre Daten nicht sehen kann und warum Sie die volle Kontrolle darüber behalten, wie Ihr Modell läuft, wird klarer, wenn man sich ansieht, was ein Open-Weight-Modell technisch ist.
Man kann es sich wie ein veröffentlichtes Buch vorstellen. Ein Labor, das Open Weights veröffentlicht, ist der Autor: Google, OpenAI oder MiniMax schreibt das Buch, trainiert also das Modell, und veröffentlicht es, sodass jeder es beziehen kann. Infercom besorgt sich ein Exemplar und nutzt es auf der eigenen Infrastruktur, um die Fragen zu beantworten, die Sie stellen.
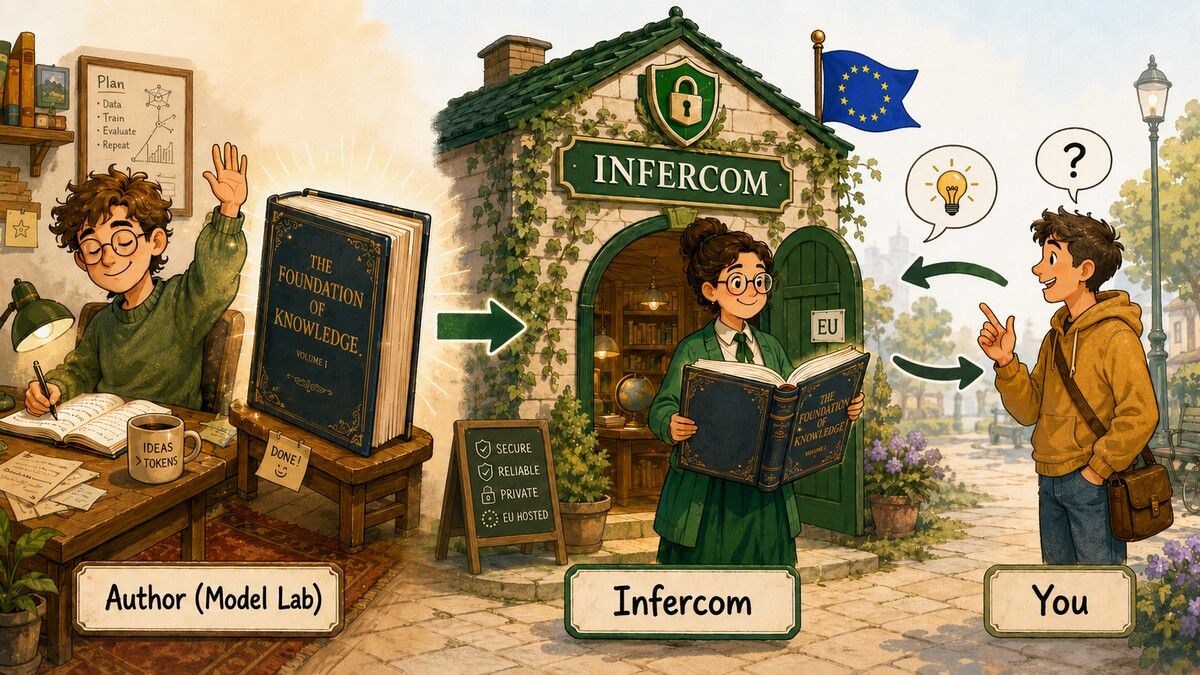
Eines kann ein veröffentlichtes Buch aber nicht. Sobald es gedruckt im Regal steht, weiß der Autor nicht, welche Bibliothek es besitzt, wer darin liest oder welche Fragen man ihm stellt. Das Buch bleibt stumm im Regal: Es kann seine Leser weder beobachten noch etwas zurückmelden. Open Weights verhalten sich genauso. Sobald ein Labor sie veröffentlicht hat, hat es keine Verbindung mehr dazu, wie diese Gewichte auf unserer Infrastruktur laufen, und keinen Einblick in die Prompts, die Sie senden.
Was tatsächlich im "Buch" steht
Ein Open-Weight-Modell ist eine Sammlung großer Binärdateien, ohne ausführbaren Code und ohne versteckte Logik. Das verbreitetste Format ist 2026 SafeTensors, das inzwischen über 1,1 Millionen Modelle auf Hugging Face verwenden. Bei einem großen Modell kommen Dutzende oder Hunderte Gigabyte an Gewichtsdateien zusammen. gpt-oss-120b, eines der Modelle, die wir anbieten, hat über 100 Milliarden Parameter. Genau diese Dateien laden wir auf unsere Infrastruktur.
Diese Dateien enthalten nur Zahlen, nämlich die gelernten Parameter. Für sich allein bewirken sie gar nichts. Sie liegen da, bis eine Inferenz-Runtime sie lädt und ausführt, und diese Runtime stammt nicht vom Labor.
Wer das Modell tatsächlich ausführt: die Runtime von SambaNova
In der Inferenz-Runtime findet die gesamte Berechnung statt, und dort liegt auch die gesamte Kontrolle. Bei Infercom ist diese Runtime die Dataflow-Architektur von SambaNova, kein GPU-Stack.
GPUs schieben die Daten zwischen jeder Rechenoperation zum Speicher und zurück. Die RDU von SambaNova (Reconfigurable Dataflow Unit) legt das Modell dagegen als durchgehenden Datenfluss an und streamt die Daten hindurch. Die Softwareschicht dahinter ist SambaFlow, der Compiler und das Orchestrierungssystem von SambaNova. SambaFlow nimmt dieselben Standard-Gewichtsdateien, die jeder herunterladen kann, und:
- übersetzt sie in optimierte Dataflow-Konfigurationen für die Hardware
- lädt sie in eine dreistufige Speicherhierarchie aus On-Chip-SRAM, HBM und DDR
- streamt Ihre Token durch die Pipeline, ohne die Speicherengpässe, die GPUs ausbremsen
- verwaltet Batching, Caching und Scheduling über alle Requests hinweg
Der Modellhersteller spielt dabei keine Rolle. Er hat das Buch geschrieben, und wir bringen es zum Laufen: auf unserer Hardware, in unserem Rechenzentrum, unter unserer Kontrolle. Das ist auch der Grund, warum Open-Weight-Modelle auf unserer Infrastruktur schnell sind: 428 Token pro Sekunde mit MiniMax M2.7. Dieser Vorteil kommt aus der Architektur, nicht nur aus der Offenheit.
Und was ist mit "Backdoors" in den Gewichten?
Die Frage ist berechtigt und verdient eine direkte Antwort: Könnten die Gewichte eines Modells eine versteckte Backdoor enthalten, die Ihre Daten heimlich irgendwohin schickt? Für jedes Open-Weight-Modell, egal von welchem Labor, lautet die Antwort nein, und der Grund liegt in der Architektur.
Um Daten abzuziehen, müssten Gewichte drei Dinge können, die unmöglich sind. Sie müssten ausführbaren Code enthalten, doch Gewichte sind Zahlen und keine Programme. Sie bräuchten Netzwerkzugriff, doch die Runtime steuert die gesamte Ein- und Ausgabe, und die Runtime gehört uns. Und sie müssten über unsere Infrastruktur hinaus wirken, doch nichts in einer Gewichtsdatei kann außerhalb der Systeme handeln, die wir kontrollieren.
Gewichte sind feste Zahlen, die eine mathematische Funktion definieren. Sie ändern sich nicht, während das Modell läuft, und sie können selbst nichts tun: Jede Berechnung führt die Runtime aus. In einer Gewichtsdatei gibt es keinen Mechanismus, der Daten irgendwohin senden könnte. Ein veröffentlichtes Buch kann seinem Autor nicht melden, wer es liest, und ein Satz Modellgewichte kann das genauso wenig.
Das ist etwas anderes als ein Risiko in der Software-Lieferkette, bei dem es um ausführbaren Code geht, der Netzwerkaufrufe absetzen kann. Modellgewichte sind kein Code, deshalb greift diese Risikokategorie nicht. Genau das erlaubt Ihnen, jedes Open-Weight-Modell von jedem Labor mit der Gewissheit einzusetzen, dass allein der Anbieter, den Sie gewählt haben, über Ihren Datenpfad bestimmt.
Aber können Sie Infercom vertrauen? (Die Frage, auf die es ankommt)
Die eigentliche Frage ist nicht, ob MiniMax oder Google Ihre Daten sehen können, denn architektonisch können sie das nicht. Die eigentliche Frage ist, ob Ihr Inferenz-Anbieter vertrauenswürdig ist. Er ist die einzige Partei, die tatsächlich in Ihrem Datenpfad sitzt.
Deshalb legen wir offen, wer wir sind und wie wir arbeiten:
- Die Hardware gehört uns. Die Infrastruktur, auf der Ihre Requests laufen, ist Eigentum von Infercom. Es ist keine gemietete Hyperscaler-Kapazität und keine geteilte Multi-Tenant-Cloud. Niemand kann einen Dritten zwingen, Zugang zu unseren Servern herauszugeben, weil zwischen Ihnen und der Hardware kein Dritter steht.
- EU-Jurisdiktion, physisch und rechtlich. Requests an unsere in der EU gehosteten Modelle laufen in einem Rechenzentrum auf EU-Boden und unterliegen EU-Recht. Es gibt keine US-Muttergesellschaft, deshalb sind wir dem US CLOUD Act nicht ausgesetzt.
- Keine dauerhafte Speicherung. Prompts und Antworten werden nie dauerhaft gespeichert, nichts aus der Inferenz landet auf einer Festplatte. Nutzungsprotokolle enthalten nur Metadaten (Zeitstempel, Token-Anzahl, verwendetes Modell).
- Ihre Prompts werden nie für Training verwendet. Wir sind eine reine Inferenz-Plattform. Mit Ihren Daten wird nichts trainiert.
- Unabhängig zertifiziert. Wir sind nach ISO 27001 für unser Informationssicherheits-Management zertifiziert. Dazu kommt CSA STAR Level 1, das den KI-spezifischen Umgang mit Daten und die Kontrollen der Model Governance abdeckt.
- DSGVO-Konformität umgesetzt. Für Enterprise-Kunden liegt ein Auftragsverarbeitungsvertrag nach Art. 28 DSGVO unterschriftsreif vor.
- Transparent bei unserem Stack. Wir überzeichnen unsere Souveränität nicht. Unsere Inferenz läuft auf Technologie von SambaNova, und SambaNova ist ein US-Unternehmen. Das sagen wir offen, statt den Stack als etwas darzustellen, das er nicht ist. Was wir kontrollieren und zusagen, ist der Teil, der über Ihre Daten bestimmt: EU-Jurisdiktion, Datenresidenz in der EU, keine dauerhafte Speicherung und kein Training mit Ihren Prompts. Uns ist lieber, dass Sie genau wissen, wo die Grenzen verlaufen, als dass wir Ihnen eine vereinfachte Geschichte verkaufen.
Das vollständige Bild mit Zertifizierungen, Verschlüsselung, Unterauftragsverarbeitern und dem genauen Umgang mit Daten finden Sie auf unserer Trust-Seite.
Unterm Strich: Bei einer proprietären API vertrauen Sie dem Modellhersteller und seiner Infrastruktur. Mit Open Weights auf Infercom nehmen Sie den Modellhersteller ganz aus der Gleichung. Sie vertrauen dann nur noch einer klar verantwortlichen Partei in der EU, die nach EU-Recht arbeitet, unabhängig zertifiziert und vertraglich gebunden ist.
Sicherheit: Warum Open Weights Ihnen die Kontrolle geben
Sicherheitsteams in Unternehmen prüfen jedes Modell zu Recht genau, bevor sie es einsetzen. Open-Weight-Modelle auf souveräner Infrastruktur geben ihnen dabei mehr Kontrolle, nicht weniger. Entscheidend ist eine Unterscheidung, die oft übersehen wird: die zwischen einem Modell und einem Dienst.
Ein Modell besteht aus den Gewichten, also aus Zahlen, die für sich allein nichts tun. Ein Dienst ist die Infrastruktur samt Anwendungscode, die diese Gewichte ausführt. Viele Sicherheitsfragen zu einem Modell sind in Wahrheit Fragen zu einem Dienst: Wie überträgt die Anwendung Daten, wo werden Prompts gespeichert, wer betreibt die Server, welche Jurisdiktion gilt? Das sind die richtigen Fragen. Mit Open Weights bestimmen Sie die Antworten, weil Sie bestimmen, wer das Modell betreibt.
Wenn Sie ein Open-Weight-Modell auf Infercom betreiben, gehört der Datenpfad uns und unterliegt der EU-Jurisdiktion. Er gehört nicht dem Modellhersteller, wo auch immer dieser sitzt. Der Modellhersteller betreibt nichts in Ihrem Workflow. Er hat Gewichte veröffentlicht und betreibt keinen Dienst, der mit Ihren Daten in Berührung kommt. Die Herkunft wird damit zu einer Frage des Verhaltens, nicht der Datensicherheit: Das Training eines Modells kann seine Ausgaben prägen, etwa den Ton, die Stärken und die Themen, die es gut beherrscht. Das prüfen Sie mit Tests an Ihrem eigenen Anwendungsfall, so wie bei jedem Modell jedes Anbieters. Es ist eine Qualitätsbewertung, die Sie selbst in der Hand haben, kein verstecktes Risiko, das Sie erben.
Das ist die Freiheit, die Open Weights Ihnen geben: Sie müssen nie die Nutzungsbedingungen, die Infrastruktur oder die Jurisdiktion eines Modellherstellers akzeptieren, nur um sein Modell zu nutzen. Sie bringen das Modell auf eine Infrastruktur, der Sie vertrauen. Wie mit Ihren Daten umgegangen wird, folgt aus dieser Entscheidung und nicht daraus, wo das Modell entwickelt wurde.
Was die Lizenzen erlauben
Lizenzen regeln, was mit den Gewichten rechtlich erlaubt ist. Als API-Kunde müssen Sie sich um die meisten Bedingungen nicht kümmern, weil wir das Modell bereitstellen. Direkt relevant werden sie, wenn Sie ein Fine-Tuning planen oder On-Premises betreiben wollen.
Gemma-Lizenz (Google). Gemma 4 erscheint unter der Standardlizenz Apache 2.0. Das ist ein deutlicher Wechsel gegenüber früheren Versionen, die eine eigene Lizenz mit Nutzungsverboten hatten, die Rechtsabteilungen von Unternehmen regelmäßig beanstandeten. Apache 2.0 erlaubt die kostenlose kommerzielle Nutzung, Änderungen, die Weitergabe und das Behalten Ihrer fine-getunten Gewichte als proprietäres Eigentum. Sie müssen nur den Lizenztext und die Namensnennung beibehalten.
gpt-oss-Lizenz (OpenAI). Die Open-Weight-Modelle von OpenAI, darunter gpt-oss-120b, erscheinen unter Apache 2.0 mit einer kurzen Nutzungsrichtlinie. Apache 2.0 gewährt die oben genannten kommerziellen Freiheiten: Nutzung, Änderung, Weitergabe und das Behalten fine-getunter Gewichte als proprietäres Eigentum. Die Nutzungsrichtlinie beschreibt, welche Nutzung als akzeptabel gilt. Bemerkenswert ist, dass OpenAI diese Gewichte nicht über die eigene API anbietet. Sie sind dafür veröffentlicht, dass jeder sie auf seiner eigenen Infrastruktur betreibt.
MiniMax-Lizenz. Die Bedingungen haben sich innerhalb der MiniMax-Modellreihe im Lauf der Zeit geändert. Frühere Modelle erschienen unter der vollständig permissiven MIT-Lizenz, und einige spätere Releases verlangen für die kommerzielle Nutzung eine Genehmigung. Für Sie spielt diese Komplexität keine Rolle: Wenn Sie MiniMax über unsere API nutzen, haben wir die nötigen kommerziellen Vereinbarungen getroffen und stellen Ihnen das Modell zu unseren eigenen Bedingungen bereit. Die Einhaltung der Lizenz ist unsere Aufgabe, nicht Ihre. Sie bauen auf dem Modell auf, ohne verfolgen zu müssen, welches Release welche Bedingungen hat.
Warum Labore Modelle verschenken. Käufer fragen oft, wo der Haken ist. Die kurze Antwort: Für die meisten Labore ist nicht das Modell das Produkt, sondern die Entwickler-Community rund um das Modell, die Cloud-Plattform, die Enterprise-Services oder der Ruf in der Forschung. An dem, was Sie bekommen, ändert diese Motivation nichts: ein leistungsfähiges Modell, das Sie über einen Anbieter Ihres Vertrauens nutzen.
Das Fazit
Open-Weight-Modelle sind in der Regel günstiger als geschlossene Spitzenmodelle. Ihr Preis richtet sich nach der Rechenleistung für die Inferenz und nicht nach der Marge eines Modellherstellers, und dieser Unterschied ist real. Die Kosten sind aber nur ein Teil der Rechnung. Open-Weight-Modelle verteilen auch die Kontrolle anders: Sie hängen von weniger Anbietern ab, halten den Modellhersteller aus Ihrem Datenpfad heraus und können besitzen, was Sie bauen.
Wer versteht, was Open Weight bedeutet, sieht klar:
- Sie sind nicht gebunden - Sie tauschen Modelle und Anbieter, wenn sich das Feld weiterentwickelt.
- Über Ihre Daten bestimmen Ihr Anbieter und Ihre Jurisdiktion - nicht das Labor und nicht dessen Herkunftsland.
- Sie behalten die Kontrolle über die Sicherheit - entscheidend sind das Vertrauen in den Anbieter und das Verhalten des Modells, und beides wählen und testen Sie selbst.
- Ein fine-getuntes Modell kann ganz Ihnen gehören - und Ihr eigener Checkpoint läuft auf Dedicated oder On-Premises.
Der Leistungsabstand, der früher einen Aufpreis für geschlossene Modelle rechtfertigte, hat sich für Alltags-Workloads weitgehend geschlossen, und er wächst nicht. Wenn die Leistung nicht mehr den Ausschlag gibt, geht es bei der Wahl um Kontrolle: Wer hält Ihre Daten, wer diktiert Ihre Bedingungen, und wem gehört, was Sie bauen? In allen drei Punkten stehen Sie mit Open Weights auf souveräner KI-Inferenz-Infrastruktur stärker da.
Häufig gestellte Fragen
Was ist der Unterschied zwischen Open-Weight- und Open-Source-KI?
Open Weight bedeutet, dass Sie die trainierten Modellparameter zum Herunterladen und Ausführen erhalten. Open Source bedeutet, dass Sie zusätzlich den Trainingscode und die Trainingsdaten bekommen, mit denen sich das Modell von Grund auf nachbauen lässt. Die meisten Modelle, die heute als "Open Source" vermarktet werden, darunter DeepSeek, Qwen und Gemma, sind technisch gesehen nur Open Weight.
Ist es sicher, ein Modell aus einem Labor in einem anderen Land zu nutzen?
Ja, wenn Sie es auf einer Infrastruktur betreiben, der Sie vertrauen. Ein Modell besteht nur aus Gewichten, also aus Zahlen, die keinen ausführbaren Code enthalten und selbst keine Daten übertragen können. Läuft ein Open-Weight-Modell auf Infercom, betreibt der Modellhersteller nichts in Ihrem Datenpfad und hat keinen Zugriff auf Ihre Requests. Die Herkunft eines Modells kann sein Verhalten prägen (seine Stärken, seinen Ton und die Themen, die es gut beherrscht), und das prüfen Sie mit Tests. Wohin Ihre Daten gehen und wer sie sehen kann, bestimmt die Herkunft aber nie. Darüber entscheiden Ihr Anbieter und dessen Jurisdiktion. Unsere vollständige Compliance-Aufstellung finden Sie auf unserer Trust-Seite.
Darf ich ein Open-Weight-Modell für die kommerzielle Nutzung per Fine-Tuning anpassen?
Das hängt von der Lizenz ab. Apache-2.0-Modelle wie Gemma 4 erlauben kommerzielles Fine-Tuning ohne Einschränkungen, andere Lizenzen enthalten Umsatzschwellen oder verlangen eine Genehmigung. Wenn Sie ein Modell per Fine-Tuning angepasst haben, kann Infercom Ihren eigenen Checkpoint mit unseren Angeboten Dedicated und On-Premises auf Infrastruktur in der EU hosten.
Wem gehört ein Modell, das ich aus Open Weights per Fine-Tuning erstelle?
Das Modell gehört Ihnen. Unter permissiven Lizenzen wie Apache 2.0 ist Ihr fine-getunter Checkpoint Ihr geistiges Eigentum: Es gibt keine Umsatzbeteiligung, keine Offenlegungspflicht und keine Genehmigungspflicht. Daten, Training und Gewichte liegen allein bei Ihnen.
Gehen meine Daten in das Herkunftsland des Modells, wenn ich ein Open-Weight-Modell nutze?
Nein. Der Modellhersteller veröffentlicht nur Gewichte und betreibt nichts in Ihrem Datenpfad. Ihre Daten gehen an die Infrastruktur Ihres Inferenz-Anbieters. Bei Infercom ist das ein Rechenzentrum in der EU unter EU-Jurisdiktion, egal wo das Modell entwickelt wurde.
Quellen
Open Weight vs. Open Source
- GEO Toolbox: Open Weights vs Open Source (2026)
- KAVRIQ: Open Weights Is Not the Same as Open Source AI
- Command Code: Open Weight vs Open Source Models
Modelllizenzen
- Google Gemma 4 Apache 2.0 License Review
- MindStudio: Gemma 4 License Analysis
- OpenAI: Introducing gpt-oss
- Decrypt: MiniMax M2.7 License Change
Modellleistung
- Artificial Analysis: Open-Source Model Leaderboard
- Epoch AI: Open-Closed Capability Gap
- Rest of World: When Americans Choose Chinese AI (MIT Sloan / Georgia Tech study)
- Digital Applied: Open-Weight vs Closed-Source Gap Analysis
Geschäftsstrategie
- Forbes: Open Source AI Is Moving From Sideshow To Strategy
- Digiwit: Open-Weight AI Models Explained
- CSIS: What to Know About Chinese AI Models