Il termine viene confuso di continuo con "open source", e la differenza è poco compresa. Per questo la chiariamo subito. Poi vediamo perché i modelli open-weight, erogati su un'infrastruttura sovrana, offrono alle aziende europee vantaggi che le API proprietarie, per come sono fatte, non possono offrire.
Prima di tutto, la differenza: open weight ≠ open source
I due termini sembrano intercambiabili, ma non lo sono.
Un modello open-weight ti dà i parametri addestrati, cioè i miliardi di numeri che codificano ciò che il modello sa. Puoi scaricarli, eseguirli e (a seconda della licenza) sottoporli a fine-tuning.
Un modello open source ti dà tutto questo più il progetto completo: il codice di addestramento, i dati di addestramento e tutto ciò che serve per ricostruire il modello da zero.
Da quando l'Open Source Initiative, l'organizzazione che mantiene l'elenco delle licenze software open source approvate, ha pubblicato la Open Source AI Definition nell'ottobre 2024, il settore traccia una linea netta tra le due cose. In pratica, quasi tutti i modelli oggi presentati come "open source", tra cui DeepSeek, Qwen e Gemma, sono in realtà solo open-weight.
| Aspetto | Open source vero e proprio | Open weight | Proprietario (GPT, Claude) |
|---|---|---|---|
| Pesi del modello | ✓ | ✓ | ✗ |
| Codice di addestramento | ✓ | ✗ | ✗ |
| Dati di addestramento | ✓ | ✗ | ✗ |
| Esecuzione sull'infrastruttura che scegli tu | ✓ | ✓ | ✗ |
| Diritti di modifica / fine-tuning | Completo | Dipende dalla licenza | Nessuno |
Per la tua azienda la riga più importante è la quarta: i modelli open-weight girano sull'infrastruttura che scegli tu. È da questa sola proprietà che nascono i vantaggi strategici.
Ma i modelli open-weight sono all'altezza?
È la prima domanda che si pone quasi chiunque, ed è quella giusta. Controllare il percorso dei dati ed evitare il lock-in non serve a nulla se il modello sottostante non è all'altezza del lavoro. Qualche anno fa la risposta onesta era "ci si avvicina, ma resta un passo indietro". Oggi non è più così.
Il divario tra i migliori modelli open-weight e i migliori modelli chiusi e proprietari si è ridotto drasticamente. Nel 2024 era spesso di 30 punti o più sui benchmark più diffusi. Nel 2026 è sceso a poche unità per la maggior parte delle attività quotidiane. Uno studio del 2026 di MIT Sloan e Georgia Tech ha rilevato che i modelli aperti raggiungono al lancio circa il 90% delle prestazioni dei modelli chiusi e spesso colmano il resto del divario nel giro di mesi, a una frazione del costo. Il tracker indipendente Epoch AI misura il ritardo in mesi, non in generazioni, e osserva che non si sta allargando.
Per ciò che la maggior parte delle aziende costruisce concretamente, come sintesi, estrazione di dati, assistenza clienti, generazione di contenuti e soprattutto coding, la differenza tra un modello aperto di punta e uno chiuso di punta in pratica spesso non si vede. Nel coding gli open weights hanno recuperato più che altrove: MiniMax e DeepSeek sono ormai vicini alla frontiera nelle attività di sviluppo software reali, ed è per questo che sono diventati popolari per l'agentic coding.
Dove si vede ancora il divario? Nel ragionamento più difficile alla frontiera, nei workflow agentici complessi a più passaggi e nella conoscenza generalista più esigente, i principali modelli chiusi mantengono un vantaggio. Non vogliamo nasconderlo: se il tuo caso d'uso si trova su quella frontiera, testa con attenzione. Ma per la grande maggioranza dei workload di produzione, i modelli open-weight non sono un compromesso da accettare in nome della sovranità. Sono validi, e puoi verificarlo tu: Artificial Analysis pubblica classifiche indipendenti e aggiornate di continuo, e il segnale più affidabile in assoluto è testare un modello candidato sul tuo workload.
Perché è importante per la tua azienda
Nessun vendor lock-in
Con un modello proprietario non ricevi mai i pesi, quindi il proprietario mantiene il controllo ovunque il modello giri fisicamente. Può essere erogato tramite la sua API o tramite un partner cloud autorizzato, ma le condizioni le detta sempre il proprietario: prezzi, limiti di capacità, policy d'uso e calendario delle dismissioni. Un partner cloud cambia chi ospita la potenza di calcolo, non chi controlla il modello. Quando una versione viene ritirata o i limiti cambiano, sei tu ad adattarti, con i suoi tempi e non con i tuoi.
I modelli open-weight spezzano questa dipendenza:
- Puoi cambiare provider senza cambiare modello. Se un provider aumenta i prezzi o peggiora il servizio, sposti lo stesso modello altrove.
- Puoi cambiare modello senza riprogettare l'architettura. Se la prossima release di MiniMax supera il modello che usi oggi, migri tramite la stessa API compatibile con OpenAI.
- Non ci sono dismissioni forzate. Un modello open-weight su cui fai affidamento non sparisce perché un fornitore ha deciso di ritirarlo.
È anche per questo che l'AI Pulse Survey di KPMG del secondo trimestre 2026 ha rilevato che il 95% delle organizzazioni ha ormai una strategia AI formale, e che lo spostamento verso i modelli open-weight è guidato soprattutto dalla flessibilità e dal contenimento dei costi. Conta la possibilità di sottrarsi all'attrazione di un unico fornitore.
I tuoi dati restano fuori dalla portata del creatore del modello
È il vantaggio che la maggior parte degli acquirenti sottovaluta.
Quando usi un'API proprietaria, ogni prompt che invii passa per l'infrastruttura del creatore del modello. Con un modello open-weight erogato da Infercom, il creatore del modello, che sia Google, OpenAI o MiniMax, non vede mai i tuoi dati. Ha pubblicato i pesi e non gestisce nulla nel percorso dei tuoi dati.
I tuoi dati arrivano invece alla nostra infrastruttura UE, sotto giurisdizione UE. Il paese d'origine del modello non conta per stabilire dove si trovano i tuoi dati, perché il creatore del modello non ospita nulla.
Chi c'è nel percorso dei tuoi dati?
La differenza tra affittare un modello proprietario ed eseguire open weights su un'infrastruttura di cui ti fidi.
API proprietaria
La tua app
Cloud del creatore del modello
Vede ogni prompt che invii.
La tua app
I tuoi dati attraversano l'infrastruttura del creatore del modello.
Open weights su Infercom
Creatore del modello
Pubblica solo i pesi
nessuna connessione
La tua app
Infercom · Infrastruttura UE
Giurisdizione UE
La tua app
Il creatore del modello è fuori dal percorso dei tuoi dati. I tuoi dati restano sotto giurisdizione UE.
Una struttura dei costi senza il margine del creatore del modello
Il prezzo delle API proprietarie include il margine del creatore del modello: l'ammortamento di ricerca e sviluppo, il profitto, il costo per difendere il proprio vantaggio competitivo. Il prezzo degli open weights riflette invece la potenza di calcolo per l'inferenza. Non c'è una licenza per utente da pagare al laboratorio né un ricarico API in più. Quando escono modelli aperti migliori, ne approfitti subito, senza rinegoziare un contratto enterprise.
Di solito il costo non è il primo motivo per cui i nostri clienti scelgono gli open weights, perché sovranità e prestazioni contano di più. La differenza strutturale però è reale, e cresce con la scala.
Puoi far girare i tuoi modelli fine-tuned
Con gli open weights puoi fare fine-tuning di un modello sui tuoi dati proprietari, adattandolo al tuo settore, alla tua terminologia e ai tuoi compiti. Con le licenze permissive il checkpoint che ne risulta è tuo: è addestrato sui tuoi dati, i pesi restano completamente privati, al laboratorio d'origine non spetta alcuna quota dei ricavi e non serve alcuna autorizzazione.
Con un'API proprietaria non è possibile, perché il modello è una scatola nera che prendi in affitto ma non possiedi mai. E una volta che hai un modello fine-tuned, ti serve un posto dove farlo girare. Le nostre offerte Dedicated e On-Premises ospitano i tuoi checkpoint fine-tuned su infrastruttura UE. Così il tuo modello personalizzato, costruito sulla tua proprietà intellettuale, gira con la stessa sovranità e lo stesso controllo di tutto il resto del tuo stack. (La nostra API condivisa eroga i modelli base, mentre i checkpoint personalizzati girano su Dedicated o On-Premises.)
Autore e libro: perché il creatore del modello non può raggiungere i tuoi dati
Per capire perché il creatore del modello non può vedere i tuoi dati, e perché mantieni il pieno controllo su come gira il tuo modello, conviene capire che cosa è un modello open-weight dal punto di vista tecnico.
Si può pensare a un libro pubblicato. Un laboratorio che rilascia open weights è l'autore: Google, OpenAI o MiniMax scrive il libro, cioè addestra il modello, e lo pubblica perché chiunque possa procurarselo. Infercom se ne procura una copia e la usa sulla propria infrastruttura per rispondere alle domande che invii.
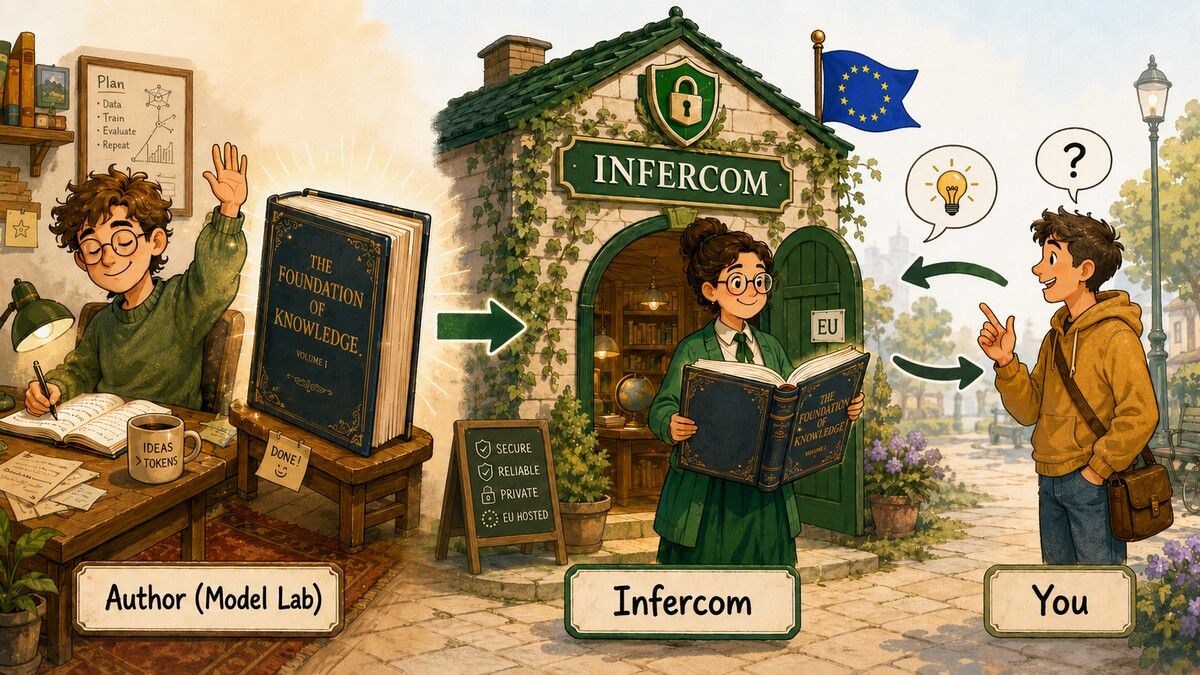
Ma c'è una cosa che un libro pubblicato non può fare. Quando il libro è stampato e sta sullo scaffale, l'autore non sa quale biblioteca lo possiede, chi lo sta leggendo o quali domande gli vengono poste. Il libro resta muto sullo scaffale: non può osservare chi lo legge né riferire nulla. Gli open weights funzionano allo stesso modo. Una volta che un laboratorio li ha pubblicati, non ha alcun legame con il modo in cui quei pesi girano sulla nostra infrastruttura, né alcuna visibilità sui prompt che invii.
Che cosa c'è dentro il "libro"
Un modello open-weight è un insieme di grandi file binari, senza nulla di eseguibile e senza logica nascosta. Nel 2026 il formato di distribuzione dominante è SafeTensors, oggi usato da oltre 1,1 milioni di modelli su Hugging Face. Un modello grande arriva a decine o centinaia di gigabyte di file di pesi. gpt-oss-120b, uno dei modelli che offriamo, ha oltre 100 miliardi di parametri. Sono proprio questi i file che carichiamo sulla nostra infrastruttura.
Questi file contengono solo numeri, cioè i parametri appresi. Da soli non fanno nulla: restano lì finché un runtime di inferenza non li carica e li esegue. E il runtime non lo fornisce il laboratorio.
Chi esegue il modello: il runtime di SambaNova
È nel runtime di inferenza che avvengono tutti i calcoli e risiede tutto il controllo, e su Infercom quel runtime è l'architettura dataflow di SambaNova, non uno stack GPU.
Le GPU spostano i dati avanti e indietro dalla memoria tra un'operazione e l'altra. L'RDU di SambaNova (Reconfigurable Dataflow Unit) dispone invece il modello come un flusso continuo e vi fa scorrere i dati. Il livello software che lo rende possibile è SambaFlow, il compilatore e sistema di orchestrazione di SambaNova. SambaFlow prende gli stessi file di pesi standard che chiunque può scaricare e:
- li traduce in configurazioni dataflow ottimizzate per l'hardware
- li carica in una gerarchia di memoria a tre livelli: SRAM on-chip, HBM e DDR
- fa scorrere i tuoi token nella pipeline senza i colli di bottiglia di memoria che frenano le GPU
- gestisce batching, caching e scheduling tra le richieste
Il creatore del modello non ha alcun ruolo in tutto questo. Ha scritto il libro, e noi lo facciamo girare: sul nostro hardware, nel nostro datacenter, sotto il nostro controllo. È anche per questo che i modelli open-weight sulla nostra infrastruttura sono veloci: 428 token al secondo con MiniMax M2.7. È un vantaggio architetturale, non solo una questione di apertura.
E le "backdoor" nei pesi?
È una domanda legittima, che merita una risposta diretta: i pesi di un modello potrebbero contenere una backdoor nascosta che invia segretamente i tuoi dati da qualche parte? Per qualsiasi modello open-weight, di qualsiasi laboratorio, la risposta è no, e il motivo è architetturale.
Per esfiltrare dati, i pesi dovrebbero fare tre cose che non possono fare. Dovrebbero contenere codice eseguibile, ma i pesi sono numeri, non programmi. Dovrebbero avere accesso alla rete, ma è il runtime a gestire tutto l'input e l'output, e il runtime è nostro. E dovrebbero raggiungere l'esterno della nostra infrastruttura, ma nulla in un file di pesi può agire oltre i sistemi che controlliamo.
I pesi sono numeri fissi che definiscono una funzione matematica. Non cambiano mentre il modello gira e non possono agire da soli: ogni calcolo lo esegue il runtime. In un file di pesi non esiste alcun meccanismo per inviare dati da qualche parte. Un libro pubblicato non può dire al suo autore chi lo sta leggendo, e nemmeno un insieme di pesi di un modello può farlo.
È una cosa diversa da un rischio di supply chain del software, dove il problema è il codice eseguibile che può effettuare chiamate di rete. I pesi di un modello non sono codice, ed è per questo che quella categoria di rischio non si applica. È ciò che ti permette di adottare qualsiasi modello open-weight, di qualsiasi laboratorio, con la certezza che il percorso dei tuoi dati dipende interamente dal provider che hai scelto.
Ma puoi fidarti di Infercom? (La domanda che conta)
La vera domanda non è se MiniMax o Google possano vedere i tuoi dati: per come è fatta l'architettura, non possono. La vera domanda è se il tuo provider di inferenza è affidabile, perché il provider è l'unica parte che sta nel percorso dei tuoi dati.
Ecco quindi chi siamo e come lavoriamo:
- L'hardware è nostro. L'infrastruttura su cui girano le tue richieste è di proprietà di Infercom: non è capacità affittata da un hyperscaler né un cloud condiviso multi-tenant. Nessuna terza parte può essere costretta a consegnare l'accesso ai nostri server, perché tra te e l'hardware non c'è nessuna terza parte.
- Giurisdizione UE, fisica e legale. Le richieste ai nostri modelli ospitati nell'UE girano in un datacenter UE, su suolo europeo, e sono regolate dal diritto UE. Non abbiamo una società madre statunitense, e quindi nessuna esposizione al CLOUD Act statunitense.
- Nessuna archiviazione persistente. Prompt e risposte non vengono mai archiviati in modo persistente, e nulla di ciò che riguarda l'inferenza viene scritto su disco. I log di utilizzo contengono solo metadati (timestamp, numero di token, modello usato).
- I tuoi prompt non vengono mai usati per l'addestramento. Siamo una piattaforma di sola inferenza. I tuoi dati non addestrano nulla.
- Certificazioni indipendenti. Siamo certificati ISO 27001 per la gestione della sicurezza delle informazioni, e CSA STAR Level 1 copre il trattamento dei dati specifico dell'AI e i controlli di governance dei modelli.
- Conformità GDPR. Per i clienti enterprise è pronto da firmare un accordo sul trattamento dei dati ai sensi dell'articolo 28 del GDPR.
- Trasparenti sul nostro stack. Non esageriamo la nostra sovranità. La nostra inferenza gira su tecnologia SambaNova, e SambaNova è un'azienda statunitense: lo diciamo apertamente invece di far passare lo stack per qualcosa che non è. Ciò che controlliamo e garantiamo è la parte che governa i tuoi dati: giurisdizione UE, residenza dei dati nell'UE, nessuna archiviazione persistente e nessun addestramento sui tuoi prompt. Preferiamo che tu sappia esattamente dove passano i confini, piuttosto che venderti una storia semplificata.
Il quadro completo, con certificazioni, crittografia, sub-responsabili del trattamento e il modo esatto in cui trattiamo i dati, è sulla nostra pagina Trust.
Riassumendo: con un'API proprietaria ti affidi al creatore del modello e alla sua infrastruttura. Con gli open weights su Infercom togli del tutto il creatore del modello dall'equazione, e resta da fidarti di un solo soggetto UE chiaramente responsabile, che opera secondo il diritto UE, è certificato in modo indipendente ed è vincolato per contratto.
Sicurezza: perché gli open weights ti danno il controllo
I team di sicurezza aziendali esaminano con ragione ogni modello che adottano, e i modelli open-weight su un'infrastruttura sovrana danno loro più controllo, non meno. La chiave è una distinzione che spesso sfugge: la differenza tra un modello e un servizio.
Un modello sono i pesi, cioè numeri che da soli non fanno nulla. Un servizio è l'infrastruttura, insieme al codice applicativo, che li esegue. Molte domande di sicurezza che si fanno su un modello riguardano in realtà un servizio: come l'app trasmette i dati, dove vengono salvati i prompt, chi gestisce i server, quale giurisdizione si applica. Sono le domande giuste, e con gli open weights le risposte le scegli tu, perché scegli tu chi fa girare il modello.
Quando esegui un modello open-weight su Infercom, il percorso dei dati è nostro, sotto giurisdizione UE, e non del creatore del modello, ovunque abbia sede. Il creatore del modello non gestisce nulla nel tuo workflow: ha pubblicato i pesi e non gestisce alcun servizio che tocchi i tuoi dati. L'origine diventa una questione di comportamento, non di sicurezza dei dati: l'addestramento di un modello può influenzarne gli output, come il tono, i punti di forza e gli argomenti che gestisce bene. Questo lo valuti con test sul tuo caso d'uso, come faresti con qualsiasi modello di qualsiasi provider. È una valutazione della qualità che controlli tu, non un rischio nascosto che erediti.
È questa la libertà che ti danno gli open weights: non devi mai accettare le condizioni di servizio, l'infrastruttura o la giurisdizione di un creatore di modelli solo per usare il suo modello. Porti il modello su un'infrastruttura di cui ti fidi, e tutto ciò che riguarda il trattamento dei tuoi dati dipende da questa scelta, non da dove il modello è stato costruito.
Che cosa ti permettono le licenze
Le licenze stabiliscono che cosa è legalmente consentito fare con i pesi. Se sei un cliente API, la maggior parte delle condizioni la gestiamo noi, perché siamo noi a erogare il modello. Diventano però rilevanti in modo diretto se vuoi fare fine-tuning o un deployment on-premises.
Licenza Gemma (Google). Gemma 4 è distribuito con la licenza standard Apache 2.0. È un cambiamento notevole rispetto alle versioni precedenti, che usavano una licenza personalizzata con una policy sugli usi vietati che gli uffici legali delle aziende segnalavano regolarmente. Apache 2.0 consente l'uso commerciale senza costi, la modifica, la redistribuzione e la possibilità di mantenere proprietari i tuoi pesi fine-tuned. Devi solo conservare il testo della licenza e l'attribuzione.
Licenza gpt-oss (OpenAI). I modelli open-weight di OpenAI, incluso gpt-oss-120b, sono distribuiti con licenza Apache 2.0 insieme a una breve policy d'uso. Apache 2.0 concede le libertà commerciali viste sopra: uso, modifica, redistribuzione e la possibilità di mantenere proprietari i pesi fine-tuned. La policy d'uso definisce che cosa si intende per uso accettabile. Da notare che questi pesi non vengono erogati tramite l'API di OpenAI: sono rilasciati perché chiunque possa eseguirli sulla propria infrastruttura.
Licenza MiniMax. Le condizioni della linea MiniMax sono cambiate nel tempo: i modelli precedenti erano rilasciati con una licenza MIT del tutto permissiva, e alcune release successive sono passate a richiedere un'autorizzazione per l'uso commerciale. Per te questa complessità non è un problema: quando accedi a MiniMax tramite la nostra API, gli accordi commerciali necessari li abbiamo noi, e ti eroghiamo il modello alle nostre condizioni. La conformità alla licenza è compito nostro, non tuo. Costruisci sul modello senza dover seguire quale release ha quali condizioni.
Perché i laboratori regalano i modelli. Chi acquista chiede spesso dov'è il trucco. La risposta breve: per la maggior parte dei laboratori il prodotto non è il modello, ma la community di sviluppatori che gli ruota intorno, la piattaforma cloud, i servizi enterprise o la reputazione nella ricerca. Le loro motivazioni non cambiano ciò che ricevi: un modello capace, a cui accedi tramite un provider di cui ti fidi.
In sintesi
I modelli open-weight di solito costano meno dei modelli chiusi di frontiera: il loro prezzo segue la potenza di calcolo per l'inferenza e non il margine di un creatore di modelli, e questa differenza è reale. Ma il costo è solo una parte del discorso. Gli open weights distribuiscono anche il controllo in modo diverso: dipendi da meno fornitori, tieni il creatore del modello fuori dal percorso dei tuoi dati e puoi possedere ciò che costruisci.
Capire che cosa significa open weight ti permette di vedere con chiarezza che:
- Non sei vincolato - cambi modelli e provider man mano che il settore si evolve.
- I tuoi dati dipendono dal tuo provider e dalla tua giurisdizione - non dal laboratorio, né dal suo paese d'origine.
- Mantieni il controllo della sicurezza - le domande che contano riguardano la fiducia nel provider e il comportamento del modello, due cose che scegli e puoi testare tu.
- Puoi possedere del tutto un modello fine-tuned - e far girare il tuo checkpoint personalizzato su Dedicated o On-Premises.
Il divario di capacità che un tempo giustificava un sovrapprezzo per i modelli chiusi si è in gran parte chiuso per i workload quotidiani, e non si sta allargando. Se le prestazioni non sono più il fattore decisivo, la scelta si riduce al controllo: chi detiene i tuoi dati, chi detta le tue condizioni e a chi appartiene ciò che costruisci. Su tutti e tre i fronti, gli open weights su un'infrastruttura sovrana di inferenza AI ti mettono in una posizione più forte.
Domande frequenti
Qual è la differenza tra AI open-weight e AI open source?
Open-weight significa che ricevi i parametri addestrati del modello da scaricare ed eseguire. Open source significa che ricevi anche il codice e i dati di addestramento necessari per riprodurre il modello da zero. La maggior parte dei modelli oggi presentati come "open source", tra cui DeepSeek, Qwen e Gemma, tecnicamente è solo open-weight.
È sicuro usare un modello creato da un laboratorio di un altro paese?
Sì, se lo esegui su un'infrastruttura di cui ti fidi. Un modello è fatto solo di pesi, cioè numeri che non contengono codice eseguibile e non possono trasmettere dati da soli. Quando un modello open-weight gira su Infercom, il creatore del modello non gestisce nulla nel percorso dei tuoi dati e non ha accesso alle tue richieste. L'origine di un modello può influenzarne il comportamento (i punti di forza, il tono e gli argomenti che gestisce bene), e questo lo valuti con i test. Ma non determina mai dove vanno i tuoi dati o chi può vederli: questo dipende dal tuo provider e dalla sua giurisdizione. Per il quadro completo della nostra conformità, consulta la nostra pagina Trust.
Posso fare fine-tuning di un modello open-weight per uso commerciale?
Dipende dalla licenza. I modelli Apache 2.0 come Gemma 4 consentono il fine-tuning commerciale senza restrizioni, mentre altri prevedono soglie di fatturato o richiedono un'autorizzazione. Dopo il fine-tuning, Infercom può ospitare il tuo checkpoint personalizzato con le offerte Dedicated e On-Premises, su infrastruttura UE.
A chi appartiene un modello che ottengo con il fine-tuning di open weights?
Il modello appartiene a te. Con licenze permissive come Apache 2.0, il tuo checkpoint fine-tuned è tua proprietà intellettuale: nessuna quota dei ricavi, nessun obbligo di divulgazione, nessuna autorizzazione necessaria. Dati, addestramento e pesi sono tuoi.
Usare un modello open-weight significa che i miei dati vanno nel paese da cui proviene il modello?
No. Il creatore del modello pubblica solo i pesi e non gestisce nulla nel percorso dei tuoi dati. I tuoi dati vanno all'infrastruttura del tuo provider di inferenza. Con Infercom si tratta di un datacenter nell'UE sotto giurisdizione UE, indipendentemente da dove è stato creato il modello.
Fonti
Open weight vs open source
- GEO Toolbox: Open Weights vs Open Source (2026)
- KAVRIQ: Open Weights Is Not the Same as Open Source AI
- Command Code: Open Weight vs Open Source Models
Licenze dei modelli
- Google Gemma 4 Apache 2.0 License Review
- MindStudio: Gemma 4 License Analysis
- OpenAI: Introducing gpt-oss
- Decrypt: MiniMax M2.7 License Change
Prestazioni dei modelli
- Artificial Analysis: Open-Source Model Leaderboard
- Epoch AI: Open-Closed Capability Gap
- Rest of World: When Americans Choose Chinese AI (MIT Sloan / Georgia Tech study)
- Digital Applied: Open-Weight vs Closed-Source Gap Analysis
Strategia aziendale
- Forbes: Open Source AI Is Moving From Sideshow To Strategy
- Digiwit: Open-Weight AI Models Explained
- CSIS: What to Know About Chinese AI Models