Begrebet bliver hele tiden blandet sammen med "open source", og mange misforstår forskellen. Derfor rydder vi op i det først. Bagefter ser vi på, hvorfor open-weight-modeller på suveræn infrastruktur giver europæiske virksomheder fordele, som proprietære API'er af strukturelle grunde ikke kan give.
Først forskellen: open weight ≠ open source
De to begreber lyder, som om de betyder det samme, men det gør de ikke.
En open-weight-model giver dig de trænede parametre, altså de milliarder af tal, der rummer det, modellen ved. Du kan downloade dem, køre dem og (afhængigt af licensen) fine-tune dem.
En open source-model giver dig alt det plus byggeplanen: træningskoden, træningsdataene og alt, hvad der skal til for at bygge modellen op fra bunden.
Siden Open Source Initiative, der vedligeholder listen over godkendte open source-softwarelicenser, udgav sin Open Source AI Definition i oktober 2024, har branchen trukket en klar grænse mellem de to. I praksis gælder: Næsten alle modeller, der i dag markedsføres som "open source", herunder DeepSeek, Qwen og Gemma, er kun open weight.
| Aspekt | Ægte open source | Open weight | Proprietær (GPT, Claude) |
|---|---|---|---|
| Modelvægte | ✓ | ✓ | ✗ |
| Træningskode | ✓ | ✗ | ✗ |
| Træningsdata | ✓ | ✗ | ✗ |
| Kører på infrastruktur efter dit valg | ✓ | ✓ | ✗ |
| Ret til ændringer / fine-tuning | Fuld | Afhænger af licensen | Ingen |
For din virksomhed er den fjerde række den vigtigste: Open-weight-modeller kører på den infrastruktur, du vælger. Det er netop den egenskab, de strategiske fordele kommer fra.
Men er open-weight-modeller overhovedet gode nok?
Det er det første, de fleste spørger om, og det er det rigtige spørgsmål. Det nytter ikke at eje din datasti og undgå lock-in, hvis modellen nedenunder ikke kan løse opgaven. For nogle år siden var det ærlige svar "tæt på, men et tydeligt skridt bagefter". Det holder ikke længere.
Afstanden mellem de bedste open-weight-modeller og de bedste lukkede, proprietære modeller er skrumpet markant. I 2024 var den ofte 30 point eller mere på gængse benchmarks. I 2026 ligger den på lave enkeltcifrede tal for de fleste hverdagsopgaver. Ifølge et studie fra MIT Sloan og Georgia Tech fra 2026 når åbne modeller omkring 90% af de lukkede modellers ydeevne ved lanceringen og lukker ofte resten af afstanden inden for måneder, til en brøkdel af prisen. Den uafhængige tracker Epoch AI måler forsinkelsen i måneder, ikke generationer, og konstaterer, at den ikke vokser.
Til det, de fleste virksomheder reelt bygger, som opsummering, dataudtræk, kundesupport, indholdsproduktion og især kodning, er forskellen på en åben og en lukket topmodel ofte usynlig i praksis. Det er inden for kodning, open weights har indhentet mest: MiniMax og DeepSeek ligger nu tæt på fronten i reelle softwareopgaver, og derfor er de blevet populære til agentic coding.
Hvor kan man stadig se forskellen? Ved den sværeste ræsonnering på forskningsfronten, ved komplekse agentiske workflows i mange trin og ved den bredeste generelle viden har de førende lukkede modeller stadig et forspring. Det lægger vi ikke skjul på: Hvis dit use case ligger der, så test grundigt. Men for langt de fleste workloads i produktion er open-weight-modeller ikke et kompromis, du accepterer for suverænitetens skyld. De er gode, og det kan du selv efterprøve: Artificial Analysis udgiver uafhængige ranglister, der løbende opdateres. Det mest pålidelige signal er dog at teste en kandidatmodel på din egen workload.
Hvorfor det betyder noget for din virksomhed
Ingen vendor lock-in
Med en proprietær model får du aldrig vægtene, så ejeren bevarer kontrollen, uanset hvor modellen fysisk kører. Den kan blive leveret via ejerens egen API eller en licenseret cloud-partner, men det er stadig ejeren, der bestemmer vilkårene: priser, kapacitetsgrænser, brugspolitikker og tidsplanen for udfasning. En cloud-partner ændrer, hvem der står for regnekraften, ikke hvem der kontrollerer modellen. Når en version udfases, eller grænserne ændres, må du tilpasse dig, på deres tidsplan og ikke din.
Open-weight-modeller bryder den afhængighed:
- Du kan skifte udbyder uden at skifte model. Hvis en udbyder hæver priserne eller leverer dårligere service, flytter du den samme model et andet sted hen.
- Du kan skifte model uden at bygge din arkitektur om. Hvis MiniMax' næste version overgår din nuværende model, migrerer du via den samme OpenAI-kompatible API.
- Du undgår tvungne udfasninger. En open-weight-model, du er afhængig af, forsvinder ikke, fordi en leverandør har besluttet at lukke den ned.
Det er også derfor, KPMG's AI Pulse-undersøgelse fra 2. kvartal 2026 viste, at 95% af organisationerne nu har en formel AI-strategi, og at skiftet mod open-weight-modeller primært drives af fleksibilitet og ønsket om at undgå omkostninger. Det handler om muligheden for at slippe fri af én leverandørs tyngdekraft.
Dine data forbliver uden for modelskaberens rækkevidde
Det er den fordel, de fleste købere undervurderer.
Når du bruger en proprietær API, passerer hver prompt, du sender, gennem modelskaberens infrastruktur. Med en open-weight-model, som Infercom kører, ser modelskaberen slet ikke dine data, hvad enten det er Google, OpenAI eller MiniMax. Modelskaberen har udgivet vægte og driver intet i din datasti.
Dine data går i stedet til vores infrastruktur i EU, under EU-jurisdiktion. Modellens oprindelsesland er uden betydning for, hvor dine data befinder sig, fordi modelskaberen ikke hoster noget.
Hvem er i din datasti?
Forskellen mellem at leje en proprietær model og at køre open weights på infrastruktur, du stoler på.
Proprietær API
Din app
Modelskaberens cloud
Ser hver prompt, du sender.
Din app
Dine data passerer gennem modelskaberens infrastruktur.
Open weights på Infercom
Modelskaber
Udgiver kun vægte
ingen forbindelse
Din app
Infercom · EU-infrastruktur
EU-jurisdiktion
Din app
Modelskaberen er uden for din datasti. Dine data forbliver under EU-jurisdiktion.
En omkostningsstruktur uden modelskaberens avance
Priserne på proprietære API'er indeholder modelskaberens avance: afskrivning af forskning og udvikling, profit og omkostningerne ved at forsvare deres markedsposition. Prisen på open weights afspejler regnekraften til inferens. Der er ingen licens per bruger til laboratoriet og intet API-tillæg oveni. Når bedre åbne modeller kommer, får du gavn af dem med det samme, uden at genforhandle en enterprise-kontrakt.
Omkostninger er som regel ikke den første grund til, at vores kunder vælger open weights, for suverænitet og ydeevne betyder mere. Men den strukturelle forskel er reel, og den vokser med skalaen.
Du kan køre dine egne fine-tunede modeller
Med open weights kan du fine-tune en model på dine egne data, så den passer til dit fagområde, din terminologi og dine opgaver. Under permissive licenser er det resulterende checkpoint dit. Det er trænet på dine data, vægtene forbliver helt private, det oprindelige laboratorium får ingen andel af omsætningen, og du behøver ingen tilladelse.
Det er ikke muligt med en proprietær API, hvor modellen er en black box, du lejer, men aldrig ejer. Og når du har en fine-tunet model, skal den køre et sted. Vores Dedicated- og On-Premises-løsninger hoster dine fine-tunede checkpoints på infrastruktur i EU. Så kører din egen model, der bygger på din intellektuelle ejendom, med samme suverænitet og kontrol som resten af din stack. (Vores delte API leverer basismodellerne, og egne checkpoints kører på Dedicated eller On-Premises.)
Forfatter og bog: Hvorfor modelskaberen ikke kan nå dine data
For at forstå, hvorfor modelskaberen ikke kan se dine data, og hvorfor du har fuld kontrol over, hvordan din model kører, hjælper det at vide, hvad en open-weight-model er rent teknisk.
Man kan sammenligne det med en udgivet bog. Et laboratorium, der udgiver open weights, er forfatteren: Google, OpenAI eller MiniMax skriver bogen, altså træner modellen, og udgiver den, så alle kan få fat i den. Infercom anskaffer et eksemplar og bruger det på vores egen infrastruktur til at besvare de spørgsmål, du sender.
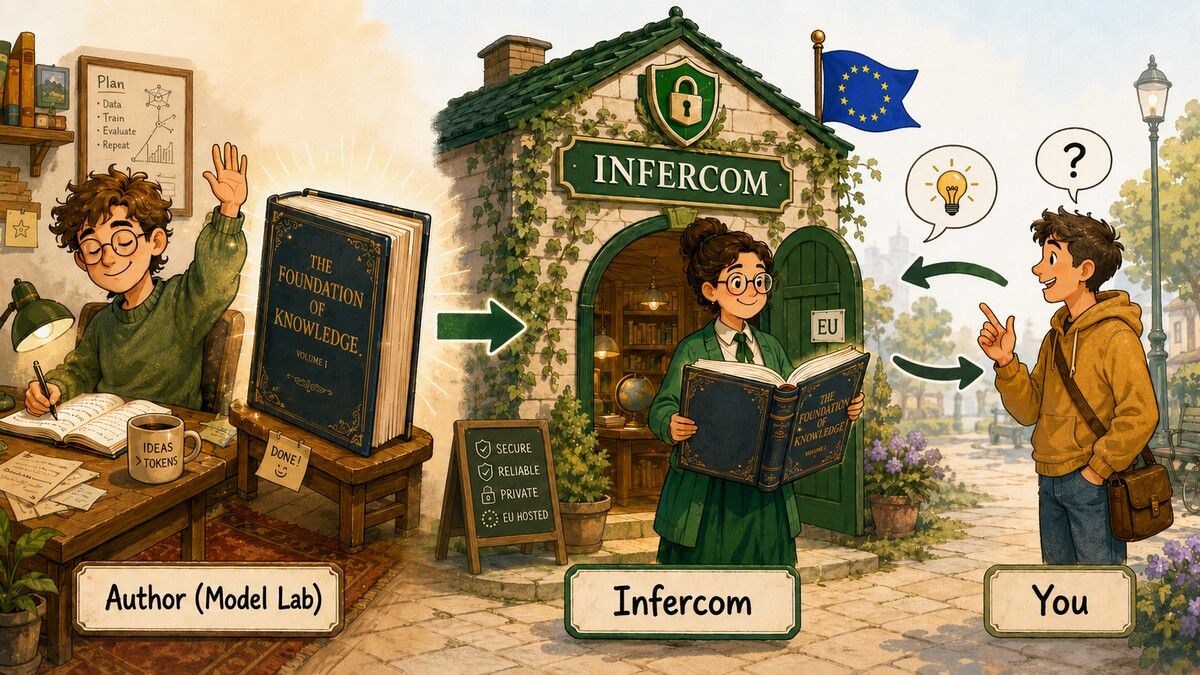
Men én ting kan en udgivet bog ikke. Når den er trykt og står på hylden, aner forfatteren ikke, hvilket bibliotek der har den, hvem der læser den, eller hvilke spørgsmål den bliver brugt til. Bogen står stille på hylden: Den kan hverken holde øje med sine læsere eller melde noget tilbage. Open weights fungerer på samme måde. Når et laboratorium har udgivet dem, har det ingen forbindelse til, hvordan vægtene kører på vores infrastruktur, og ingen indsigt i de prompts, du sender.
Hvad der står i "bogen"
En open-weight-model er en samling store binære filer, uden eksekverbar kode og uden skjult logik. Det mest udbredte distributionsformat i 2026 er SafeTensors, som nu bruges af over 1,1 millioner modeller på Hugging Face. En stor model fylder flere titals eller hundredvis af gigabyte i vægtfiler. gpt-oss-120b, en af de modeller vi tilbyder, har over 100 milliarder parametre. Det er netop de filer, vi indlæser på vores infrastruktur.
Filerne indeholder kun tal, nemlig de lærte parametre. Alene gør de ingenting. De ligger stille, indtil en inferens-runtime indlæser og kører dem, og den runtime leverer laboratoriet ikke.
Hvem der kører modellen: SambaNovas runtime
Det er i inferens-runtimen, al beregning og al kontrol ligger, og hos Infercom er den runtime SambaNovas dataflow-arkitektur, ikke en GPU-stack.
GPU'er flytter data frem og tilbage til hukommelsen mellem hver operation. SambaNovas RDU (Reconfigurable Dataflow Unit) lægger i stedet modellen ud som et sammenhængende flow og streamer data igennem det. Softwarelaget bag er SambaFlow, SambaNovas compiler og orkestreringssystem. SambaFlow tager de samme standard-vægtfiler, som alle kan downloade, og:
- oversætter dem til optimerede dataflow-konfigurationer til hardwaren
- indlæser dem i et hukommelseshierarki i tre niveauer: on-chip SRAM, HBM og DDR
- streamer dine tokens gennem pipelinen uden de flaskehalse i hukommelsen, der bremser GPU'er
- styrer batching, caching og planlægning på tværs af forespørgsler
Modelskaberen spiller ingen rolle i noget af det. De skrev bogen, og vi kører den: på vores hardware, i vores datacenter, under vores kontrol. Det er også derfor, open-weight-modeller er hurtige på vores infrastruktur: 428 tokens per sekund på MiniMax M2.7. Fordelen kommer fra arkitekturen, ikke kun fra åbenheden.
Hvad med "bagdøre" i vægtene?
Det er et rimeligt spørgsmål, som fortjener et direkte svar: Kan en models vægte indeholde en skjult bagdør, der i al hemmelighed sender dine data et sted hen? For enhver open-weight-model, fra ethvert laboratorium, er svaret nej, og grunden ligger i arkitekturen.
For at lække data skulle vægtene kunne tre ting, som de ikke kan. De skulle indeholde eksekverbar kode, men vægte er tal, ikke programmer. De skulle have netværksadgang, men runtimen håndterer al input og output, og runtimen er vores. Og de skulle kunne nå uden for vores infrastruktur, men intet i en vægtfil kan handle ud over de systemer, vi kontrollerer.
Vægte er faste tal, der definerer en matematisk funktion. De ændrer sig ikke, mens modellen kører, og de kan ikke handle på egen hånd: Alle beregninger udføres af runtimen. Der findes ingen mekanisme i en vægtfil, der kan sende data nogen steder hen. En udgivet bog kan ikke fortælle sin forfatter, hvem der læser den, og det kan et sæt modelvægte heller ikke.
Det er noget andet end en risiko i softwarens forsyningskæde, hvor bekymringen er eksekverbar kode, der kan foretage netværkskald. Modelvægte er ikke kode, og derfor gælder den risikokategori ikke. Det er det, der gør, at du trygt kan tage enhver open-weight-model fra ethvert laboratorium i brug, velvidende at din datasti udelukkende styres af den udbyder, du har valgt.
Men kan du stole på Infercom? (Det spørgsmål, der betyder noget)
Det afgørende spørgsmål er ikke, om MiniMax eller Google kan se dine data, for arkitektonisk kan de ikke. Det afgørende spørgsmål er, om din inferensudbyder er til at stole på, fordi udbyderen er den ene part, der sidder i din datasti.
Så her er, hvem vi er, og hvordan vi arbejder:
- Vi ejer hardwaren. Den infrastruktur, dine forespørgsler kører på, ejes af Infercom. Det er ikke lejet hyperscaler-kapacitet og ikke en delt multi-tenant-cloud. Ingen tredjepart kan tvinges til at udlevere adgang til vores servere, fordi der ikke står nogen tredjepart mellem dig og hardwaren.
- EU-jurisdiktion, fysisk og juridisk. Forespørgsler til vores EU-hostede modeller kører i et datacenter på EU-jord under EU-lovgivning. Der er intet amerikansk moderselskab, og derfor er vi ikke eksponeret for den amerikanske CLOUD Act.
- Ingen permanent lagring. Prompts og svar gemmes aldrig permanent, og intet fra inferensen skrives til disk. Brugslogs indeholder kun metadata (tidsstempler, antal tokens, anvendt model).
- Dine prompts bruges aldrig til træning. Vi er en ren inferensplatform. Dine data træner ingenting.
- Uafhængigt certificeret. Vi er ISO 27001-certificeret for vores styring af informationssikkerhed, og CSA STAR Level 1 dækker den AI-specifikke databehandling og kontrollerne for model governance.
- GDPR-compliance på plads. En databehandleraftale efter GDPR artikel 28 ligger klar til underskrift for enterprise-kunder.
- Åbne om vores stack. Vi overdriver ikke vores suverænitet. Vores inferens kører på SambaNovas teknologi, og SambaNova er en amerikansk virksomhed. Det siger vi åbent i stedet for at lade som om, stacken er noget, den ikke er. Det, vi kontrollerer og forpligter os til, er den del, der styrer dine data: EU-jurisdiktion, dataresidency i EU, ingen permanent lagring og ingen træning på dine prompts. Vi vil hellere have, at du ved præcis, hvor grænserne går, end sælge dig en forenklet historie.
Hele billedet med certificeringer, kryptering, underdatabehandlere og præcis hvordan data håndteres finder du på vores Trust-side.
Kort sagt: Med en proprietær API stoler du på modelskaberen og deres infrastruktur. Med open weights på Infercom fjerner du modelskaberen helt fra ligningen og skal kun stole på én tydeligt ansvarlig part i EU, som arbejder under EU-lovgivning, er uafhængigt certificeret og kontraktligt forpligtet.
Sikkerhed: Hvorfor open weights giver dig kontrollen
Sikkerhedsteams i virksomheder gennemgår med rette enhver model, de tager i brug, og open-weight-modeller på suveræn infrastruktur giver dem mere kontrol, ikke mindre. Nøglen er en skelnen, der ofte overses: forskellen mellem en model og en tjeneste.
En model er vægtene, altså tal, der ikke gør noget i sig selv. En tjeneste er infrastrukturen og applikationskoden, der kører dem. Mange af de sikkerhedsspørgsmål, folk stiller om en model, handler i virkeligheden om en tjeneste: Hvordan overfører appen data, hvor gemmes prompts, hvem driver serverne, og hvilken jurisdiktion gælder? Det er de rigtige spørgsmål at stille. Med open weights vælger du selv svarene, fordi du vælger, hvem der kører modellen.
Når du kører en open-weight-model på Infercom, er datastien vores, under EU-jurisdiktion, og ikke modelskaberens, uanset hvor den har hjemme. Modelskaberen driver intet i dit workflow. De har udgivet vægte og kører ingen tjeneste, der rører dine data. Oprindelsen bliver et spørgsmål om adfærd, ikke om datasikkerhed: En models træning kan præge dens output, for eksempel tonen, styrkerne og de emner, den håndterer godt. Det vurderer du ved at teste den på dit eget use case, præcis som du ville gøre med enhver model fra enhver udbyder. Det er en kvalitetsvurdering, du selv styrer, ikke en skjult risiko, du arver.
Det er den frihed, open weights giver dig: Du behøver aldrig at acceptere en modelskabers servicevilkår, infrastruktur eller jurisdiktion kun for at bruge deres model. Du bringer modellen over på infrastruktur, du stoler på, og alt ved, hvordan dine data håndteres, følger af det valg og ikke af, hvor modellen blev bygget.
Hvad licenserne tillader dig
Licenser afgør, hvad der er lovligt at gøre med vægtene. Som API-kunde håndterer vi de fleste vilkår for dig, fordi vi leverer modellen. Men de får direkte betydning, hvis du planlægger at fine-tune eller køre on-premises.
Gemma-licens (Google). Gemma 4 udgives under standardlicensen Apache 2.0. Det er et markant skifte fra tidligere versioner, der brugte en egen licens med en politik for forbudt brug, som juridiske afdelinger i virksomheder jævnligt slog alarm over. Apache 2.0 tillader kommerciel brug uden gebyrer, ændringer, videredistribution og at holde dine fine-tunede vægte proprietære. Du skal kun bevare licensteksten og kildeangivelsen.
gpt-oss-licens (OpenAI). OpenAIs open-weight-modeller, herunder gpt-oss-120b, udgives under Apache 2.0 sammen med en kort brugspolitik. Apache 2.0 giver de kommercielle friheder, der er nævnt ovenfor: brug, ændringer, videredistribution og at holde fine-tunede vægte proprietære. Brugspolitikken beskriver, hvad der regnes for acceptabel brug. Værd at bemærke: Disse vægte leveres ikke via OpenAIs egen API, men er udgivet, så alle kan køre dem på deres egen infrastruktur.
MiniMax-licens. Vilkårene for MiniMax-modellerne har ændret sig over tid. Tidligere modeller blev udgivet under en fuldt permissiv MIT-licens, og nogle senere versioner kræver tilladelse til kommerciel brug. For dig er den kompleksitet ikke et problem: Når du bruger MiniMax via vores API, har vi de nødvendige kommercielle aftaler på plads og leverer modellen til dig på vores egne vilkår. Licensoverholdelse er vores opgave, ikke din. Du bygger videre på modellen uden at holde styr på, hvilken version der har hvilke betingelser.
Hvorfor laboratorier giver modeller væk. Købere spørger ofte, hvor hagen er. Det korte svar: For de fleste laboratorier er modellen ikke produktet. Det er udviklerfællesskabet omkring den, cloud-platformen, enterprise-tjenesterne eller omdømmet i forskningen. Deres motivation ændrer ikke på det, du får: en stærk model, som du bruger via en udbyder, du stoler på.
Konklusion
Open-weight-modeller er som regel billigere end lukkede frontier-modeller. Deres priser følger regnekraften til inferens og ikke en modelskabers avance, og den forskel er reel. Men prisen er kun en del af sagen. De giver også en anden fordeling af kontrollen: Du er afhængig af færre leverandører, holder modelskaberen ude af din datasti og kan eje det, du bygger.
Når du forstår, hvad open weight betyder, står det klart:
- Du er ikke låst fast - du skifter modeller og udbydere, efterhånden som feltet udvikler sig.
- Dine data styres af din udbyder og din jurisdiktion - ikke af laboratoriet og ikke af dets oprindelsesland.
- Du bevarer kontrollen over sikkerheden - de spørgsmål, der betyder noget, handler om tillid til udbyderen og om modellens adfærd, og begge dele vælger og tester du selv.
- Du kan eje en fine-tunet model fuldt ud - og køre dit eget checkpoint på Dedicated eller On-Premises.
Den afstand i ydeevne, der engang retfærdiggjorde en merpris for lukkede modeller, er stort set lukket for hverdagens workloads, og den vokser ikke. Når ydeevnen ikke længere er det afgørende, handler valget om kontrol: Hvem har dine data, hvem dikterer dine vilkår, og hvem ejer det, du bygger? På alle tre punkter står du stærkere med open weights på suveræn infrastruktur til AI-inferens.
Ofte stillede spørgsmål
Hvad er forskellen på open-weight og open source-AI?
Open weight betyder, at du får de trænede modelparametre til at downloade og køre. Open source betyder, at du også får træningskoden og de data, der skal til for at genskabe modellen fra bunden. De fleste modeller, der i dag markedsføres som "open source", herunder DeepSeek, Qwen og Gemma, er teknisk set kun open weight.
Er det sikkert at bruge en model, der er bygget af et laboratorium i et andet land?
Ja, når du kører den på infrastruktur, du stoler på. En model er kun vægte, altså tal, der ikke indeholder eksekverbar kode og ikke selv kan sende data. Når en open-weight-model kører på Infercom, driver modelskaberen intet i din datasti og har ingen adgang til dine forespørgsler. En models oprindelse kan præge dens adfærd (dens styrker, tone og de emner, den håndterer godt), og det vurderer du ved at teste. Men oprindelsen bestemmer aldrig, hvor dine data går hen, eller hvem der kan se dem. Det styres af din udbyder og dennes jurisdiktion. Se vores Trust-side for vores samlede compliance-grundlag.
Kan jeg fine-tune en open-weight-model til kommerciel brug?
Det afhænger af licensen. Apache 2.0-modeller som Gemma 4 tillader kommerciel fine-tuning uden begrænsninger, mens andre har omsætningsgrænser eller kræver tilladelse. Når du har fine-tunet en model, kan Infercom hoste dit eget checkpoint på vores Dedicated- og On-Premises-løsninger på infrastruktur i EU.
Hvem ejer en model, jeg fine-tuner ud fra open weights?
Det gør du. Under permissive licenser som Apache 2.0 er dit fine-tunede checkpoint din intellektuelle ejendom, uden andel af omsætningen, uden krav om offentliggørelse og uden behov for tilladelse. Data, træning og vægte er dine.
Betyder brugen af en open-weight-model, at mine data sendes til det land, modellen kommer fra?
Nej. Modelskaberen udgiver kun vægte og driver intet i din datasti. Dine data går til din inferensudbyders infrastruktur. Hos Infercom er det et datacenter i EU under EU-jurisdiktion, uanset hvor modellen er skabt.
Kilder
Open weight vs. open source
- GEO Toolbox: Open Weights vs Open Source (2026)
- KAVRIQ: Open Weights Is Not the Same as Open Source AI
- Command Code: Open Weight vs Open Source Models
Modellicenser
- Google Gemma 4 Apache 2.0 License Review
- MindStudio: Gemma 4 License Analysis
- OpenAI: Introducing gpt-oss
- Decrypt: MiniMax M2.7 License Change
Modelydeevne
- Artificial Analysis: Open-Source Model Leaderboard
- Epoch AI: Open-Closed Capability Gap
- Rest of World: When Americans Choose Chinese AI (MIT Sloan / Georgia Tech study)
- Digital Applied: Open-Weight vs Closed-Source Gap Analysis
Forretningsstrategi
- Forbes: Open Source AI Is Moving From Sideshow To Strategy
- Digiwit: Open-Weight AI Models Explained
- CSIS: What to Know About Chinese AI Models